诊断蛋白组合的研究价值取决于所比较的人群:早期发现关注早期病例与目标筛查人群,鉴别诊断关注具有相似临床表现的不同疾病,联合检测则关注蛋白对已有指标的补充。本服务按目标任务完成体液蛋白组检测、候选筛选、分类建模与性能分析,保留病例和对照的采样条件、候选分子及模型参数,并在具备独立队列时评价新受试者中的预测表现。
适合开展哪些研究
疾病早期发现项目可围绕早期病例与目标筛查人群设计队列,并同步覆盖主要年龄层、疾病阶段及相关临床背景;疾病鉴别项目可纳入具有相似症状、炎症或良性病变的对照,评价蛋白组合在实际鉴别场景中的表现。已有常规检测指标的项目,可比较常规指标、蛋白组合与联合模型,分析蛋白信息带来的补充价值。
对于已经获得候选蛋白的项目,可围绕既定分子集合开展组合优化、特征稳定性分析和验证队列评价。对于具备多中心或连续入组条件的研究,可按中心或时间安排开发与验证数据,保留与未来应用场景接近的人群构成,并进一步分析不同疾病阶段与临床亚组的表现。
服务特色 比较蛋白与临床指标的表现
候选蛋白分别评价疾病关联、定量覆盖、重复建模入选情况及检测可行性。常规指标、蛋白组合与联合模型采用相同人群和评价条件,比较加入蛋白信息后区分度、概率校准与阈值结果的变化。重点候选同时附功能注释及其在病例、对照中的丰度分布,将分子层关联与模型层分类表现分别呈现。
区分度评价病例与对照的排序,概率校准评价预测概率与观察病例比例的吻合程度,阈值结果则给出漏检、误报和需要后续检查的人数。筛查或鉴别任务对这些结果的要求有所不同,候选模型按预设用途比较,并列明相应人群与判定条件。
分析项目
诊断场景与分析数据
- 目标人群与对照结构:围绕筛查、辅助诊断或鉴别诊断定义病例及相应对照,汇总疾病阶段和临床构成。
- 样本与蛋白覆盖:统计各诊断类别的可用样本、蛋白检出率及缺失分布,形成用于候选分析和建模的数据集。
- 批次与类别分布:对应检测批次、病例类别和样本来源,分析技术因素与诊断分组的关系,选择具有可比性的数据。
- 建模变量整理:对应蛋白、年龄、性别及其他临床指标,明确变量类型、单位和可获得时间,形成预测变量表。
- 临床参照指标分布:展示常规肿瘤标志物及临床变量在病例和对照中的分布,输出个体散点及组间重叠情况。
单蛋白候选分析
- 候选丰度分布:展示候选蛋白在病例、对照和预设疾病亚组中的丰度,输出样本分布图与组间效应。
- 单蛋白诊断关联:估计蛋白与病例状态的关联,报告比值比(OR)、95%置信区间和多重检验结果。
- 协变量调整关联:将预设年龄、性别及临床因素纳入回归模型,获得调整后的候选蛋白效应。
- 单蛋白区分度:计算单蛋白ROC曲线及AUC,作为候选蛋白排序和组合建模的参考结果。
蛋白组合与临床联合模型
- 临床参照模型:使用拟应用场景可获得的常规临床指标建立参照,提供与蛋白模型相同条件下的预测结果。
- 蛋白组合模型:在训练数据内完成蛋白过滤、缺失处理、标准化、候选选择和模型拟合,形成多蛋白组合。
- 蛋白与临床联合模型:组合蛋白信息和临床变量,估计两类信息共同用于诊断分类时的预测表现。
- 特征数与模型复杂度:统计各次建模保留的蛋白数和模型系数,展示组合规模及其随样本划分的变化。
- 训练内参数选择:在训练样本内比较正则化强度或其他模型参数,保存所选参数和对应特征组合。
交叉验证与候选稳定性
- 嵌套交叉验证:外层划分用于获得受试者预测,内层完成特征和参数选择,汇总每位受试者的折外概率。
- 重复划分性能分布:在重复样本划分中计算各模型性能,报告均值、区间及重复间变异。
- 内外层性能对应:比较参数选择时的内层评分与相应外层测试评分,输出各训练折的性能差值和重复分布。
- 候选入选频率:统计蛋白在各训练折中的入选比例,输出稳定性排序和高频候选集合。
- 模型系数方向:比较重复建模中候选蛋白系数的方向与幅度,展示同一候选对预测结果的贡献变化。
区分度与判定阈值
- ROC曲线与AUC:使用折外预测或独立队列预测比较临床、蛋白及联合模型,报告区分度及其置信区间。
- 精确率与召回率:利用相同预测绘制PR曲线并计算平均精确率,结合评价集合中的病例比例描述分类表现。
- 分类混淆矩阵:按预定阈值统计真实类别与预测类别,展示病例及对照各自的分类结果。
- 敏感度与特异度:沿判定阈值评估病例检出和对照识别表现,并报告研究指定工作点的指标及区间。
- 阈值性能曲线:同时展示不同阈值对应的敏感度、特异度和预测阳性比例,便于选择目标使用条件下的工作点。
- 早期或指定亚组表现:将既定蛋白组合和预测规则应用于早期病例及相应对照,报告该亚组的区分度和阈值性能。
概率校准与蛋白增量信息
- 折外概率分布:分别展示病例、对照及预设疾病阶段中的受试者预测概率,呈现组间重叠与各亚组的概率范围。
- 校准曲线:比较模型预测概率与实际病例比例,展示低、中、高预测范围的概率一致性。
- 校准指标与预测误差:计算校准截距、斜率和Brier评分等指标,从概率层评价预测偏移与误差。
- 模型间性能比较:在相同受试者和预测划分下比较三类模型,报告加入蛋白信息后区分度、校准及阈值表现的变化。
- 人群患病率适配:在具有目标人群患病率资料时,估计指定工作点的阳性和阴性预测值,注明对应人群条件。
独立队列应用与结果提供
- 最终模型参数:使用开发样本拟合所选方案,形成蛋白清单、数据处理参数、系数、预测公式和判定阈值。
- 独立队列评价:在相同诊断定义和采样窗口的独立队列中应用既定模型,报告区分度、校准与阈值性能。
- 中心与人群分层:按中心、疾病阶段和预设临床亚组汇总预测结果,描述模型在不同样本构成中的表现。
- 候选及预测结果表:提供受试者预测、候选关联、入选频率、模型参数、性能结果与相应图件。
核心分析 候选蛋白与组合构建
病例与对照定义、分组构成、蛋白覆盖和临床变量共同确定候选关联分析的数据范围。单蛋白结果列出效应方向、比值比或其他适用效应量、置信区间及多重检验结果。年龄、性别和相关临床指标按设计纳入模型,调整前后的效应并列报告,显示候选关联在考虑这些变量后如何变化。
组合开发按特征数量、样本规模及目标用途选择惩罚回归或其他适用的机器学习方法。训练与评价以独立受试者划分,特征筛选、缺失处理、标准化和参数选择均在训练数据中完成,然后为相应评价样本生成预测。重复抽样记录蛋白入选频率、系数方向及组合规模,比较性能相近时不同方案所需的检测复杂度。
深入分析 性能 阈值与临床亚组
ROC曲线展示灵敏度与特异度在不同阈值下的对应关系,曲线下面积汇总区分度;精确率—召回率曲线展示预测阳性中的病例比例与病例覆盖情况。常规指标、蛋白模型和联合模型使用一致的数据划分比较,并报告相应区间估计。针对早期病例或特定临床亚组,可沿用既定模型计算结果,研究模型表现随人群特征的变化。
校准曲线显示预测概率与目标人群观察病例比例的对应,概率误差汇总两者的偏差。按预设灵敏度或特异度选择阈值后,报告混淆矩阵及分类指标,阳性和阴性预测值按目标患病比例计算。独立验证沿用选定蛋白集、预处理参数、模型系数与阈值,评价新入组受试者的区分度和校准。
样本与临床资料
项目可提供血浆、血清或其他与研究用途相匹配的体液样本,由易算生物安排前处理、质谱检测和蛋白定量。病例与对照采用一致的采样窗口及保存条件,检测安排兼顾组别、中心和批次分布。早期发现项目重点记录采样相对于确诊和治疗的时间,鉴别研究保留相关疾病、良性病变与炎症等对照类别。
资料包括独立受试者编号、样本编号、病例状态、诊断依据、疾病分期、年龄、性别及主要临床协变量,并附拟比较的常规指标。已有模型验证需提供候选蛋白、变量处理和计算规则。队列规模根据病例与对照数、目标性能的估计精度、亚组设置及模型复杂度规划,开发和验证阶段分别估计所需样本。
服务流程
场景与队列设计:确定目标疾病、人群、对照类别、采样窗口和主要评价指标。
检测与候选筛选:完成体液蛋白定量,结合临床信息识别疾病相关蛋白及可开展组合研究的候选范围。
组合与性能分析:建立常规、蛋白及联合模型,完成交叉验证、稳定性、校准和阈值分析。
独立验证与交付:依据项目阶段评价新队列结果,整理候选组合、模型资料及后续检测开发所需信息。
交付内容
交付质量与定量结果、候选蛋白关联表、模型特征与系数、个体预测结果、性能评价表以及ROC、精确率—召回率、校准和特征稳定性等图件。阈值结果注明适用队列与对应的分类指标,模型文件配套提供输入字段和变量处理方式,便于在后续研究中使用相同规则计算。
专题报告比较蛋白组合与临床参照在同一鉴别任务中的表现,说明候选的疾病关联、检测覆盖和模型贡献。拟精简的面板列出候选相关性及删减后的性能结果,靶向检测和独立验证建议则注明目标人群、样本条件、临床亚组与主要评价指标。
项目咨询:请提供研究问题、样本类型与数量、分组设计及相关病理、临床或配套组学资料。多组学与生信定制咨询:multiomics@omicsolution.com。
图文示例
图文为分析方法、公开数据再分析或研究示例。示例中的样本数量、效应和模型性能对应各自数据与分析条件,不代表其他项目的结果保证。服务用于科研;候选关系与预测结果不能替代机制验证、独立队列验证或临床诊断。
图1 诊断生物标志物的分析设计
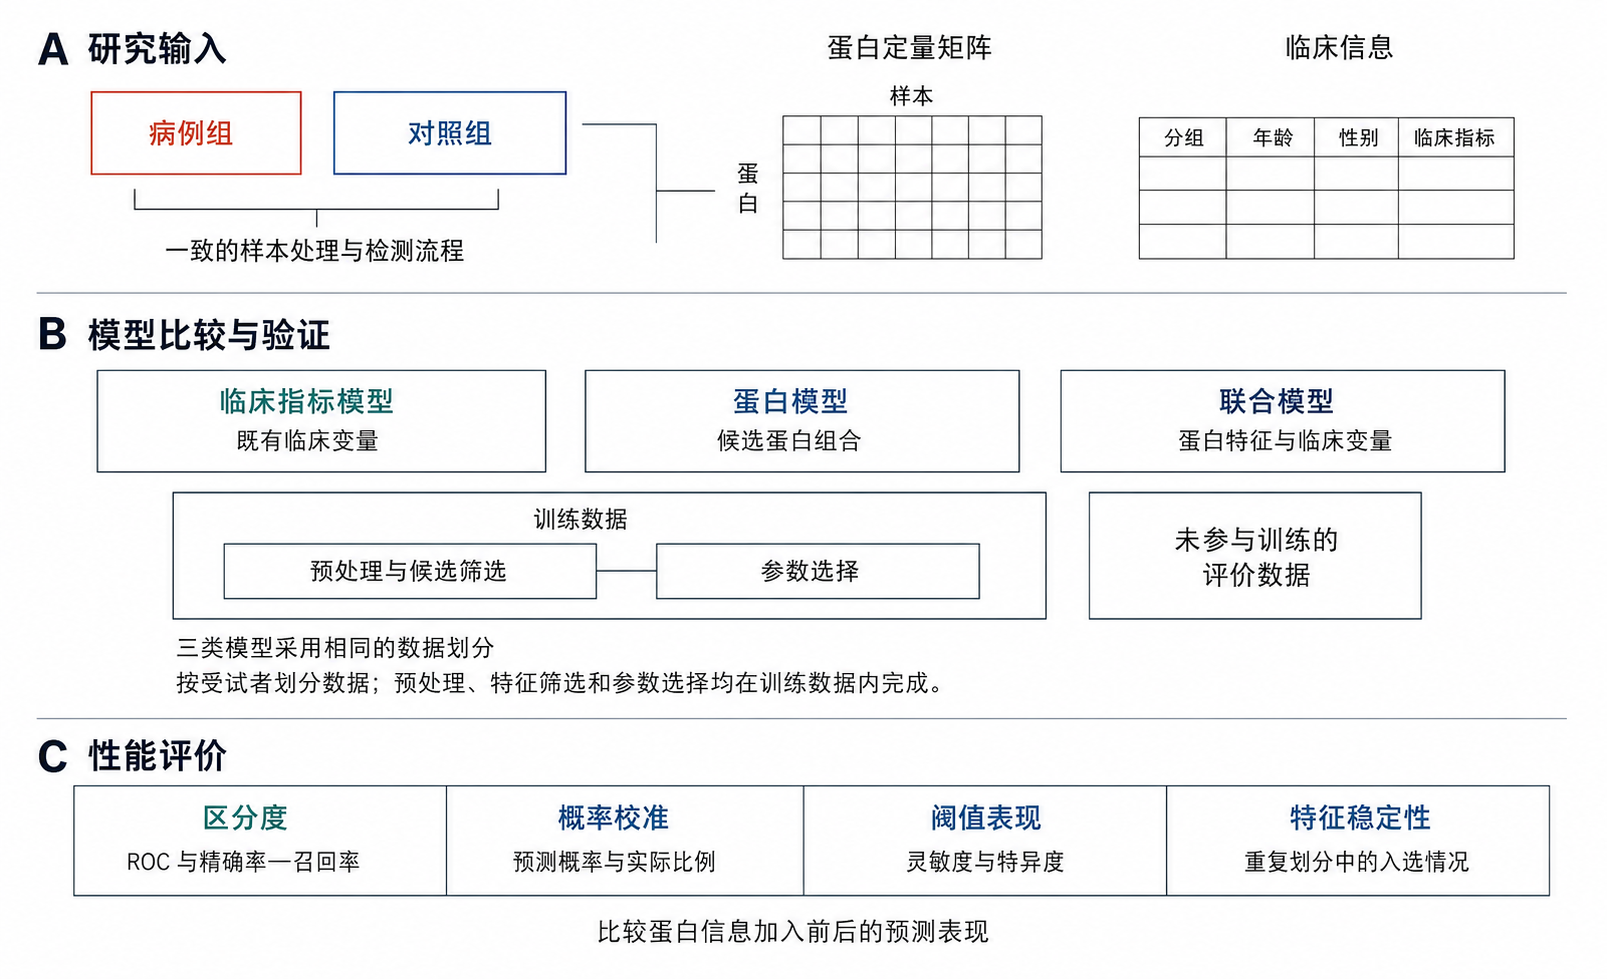
易算生物诊断生物标志物分析设计示意。
病例与对照应采用一致的样本处理和检测流程,并在比较时考虑年龄、性别等临床变量。候选筛选和参数选择在训练数据内完成;同一受试者的样本在数据划分时保持同组,再以未参与训练的样本评价模型。
图2 诊断候选蛋白的个体丰度分布
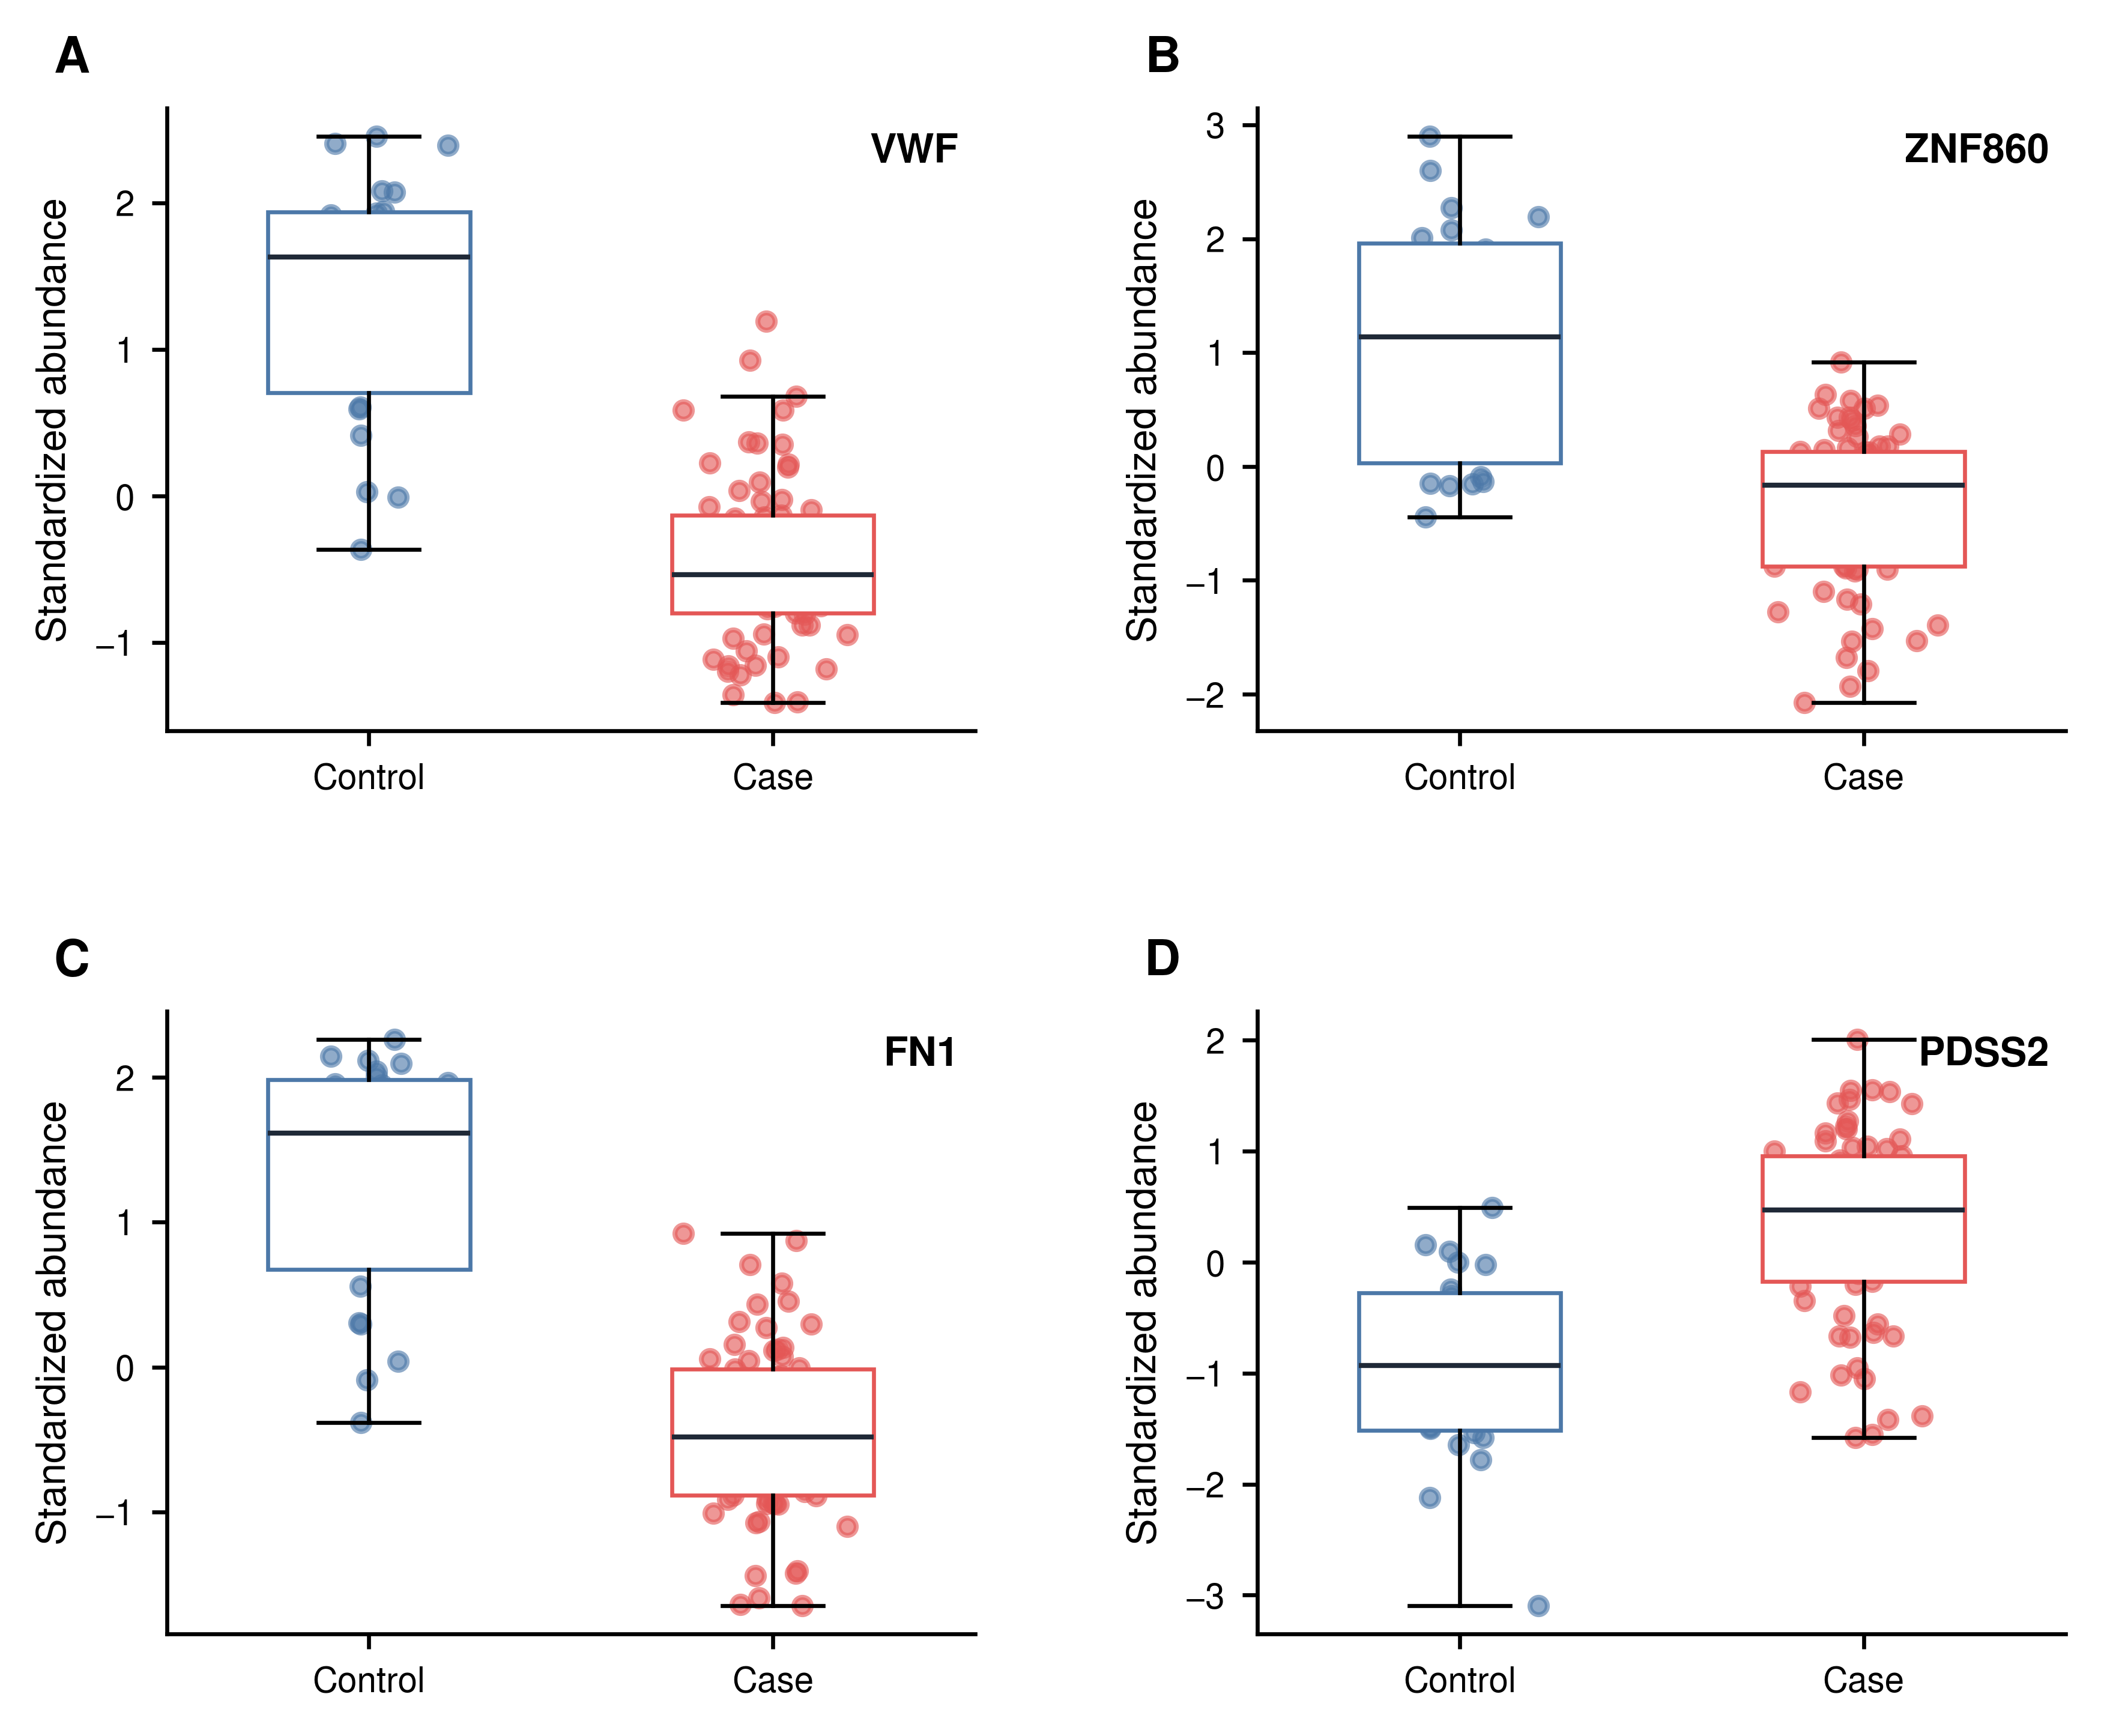
易算生物体液蛋白组诊断生物标志物分析示例。
箱线图显示病例与对照的候选丰度分布,个体点保留组内差异及两组重叠。中位数差别、分布范围和极值共同描述单蛋白信号;重复入选频率另从模型层评价候选随训练样本改变的稳定性。
图3 常规指标与年龄的组间分布
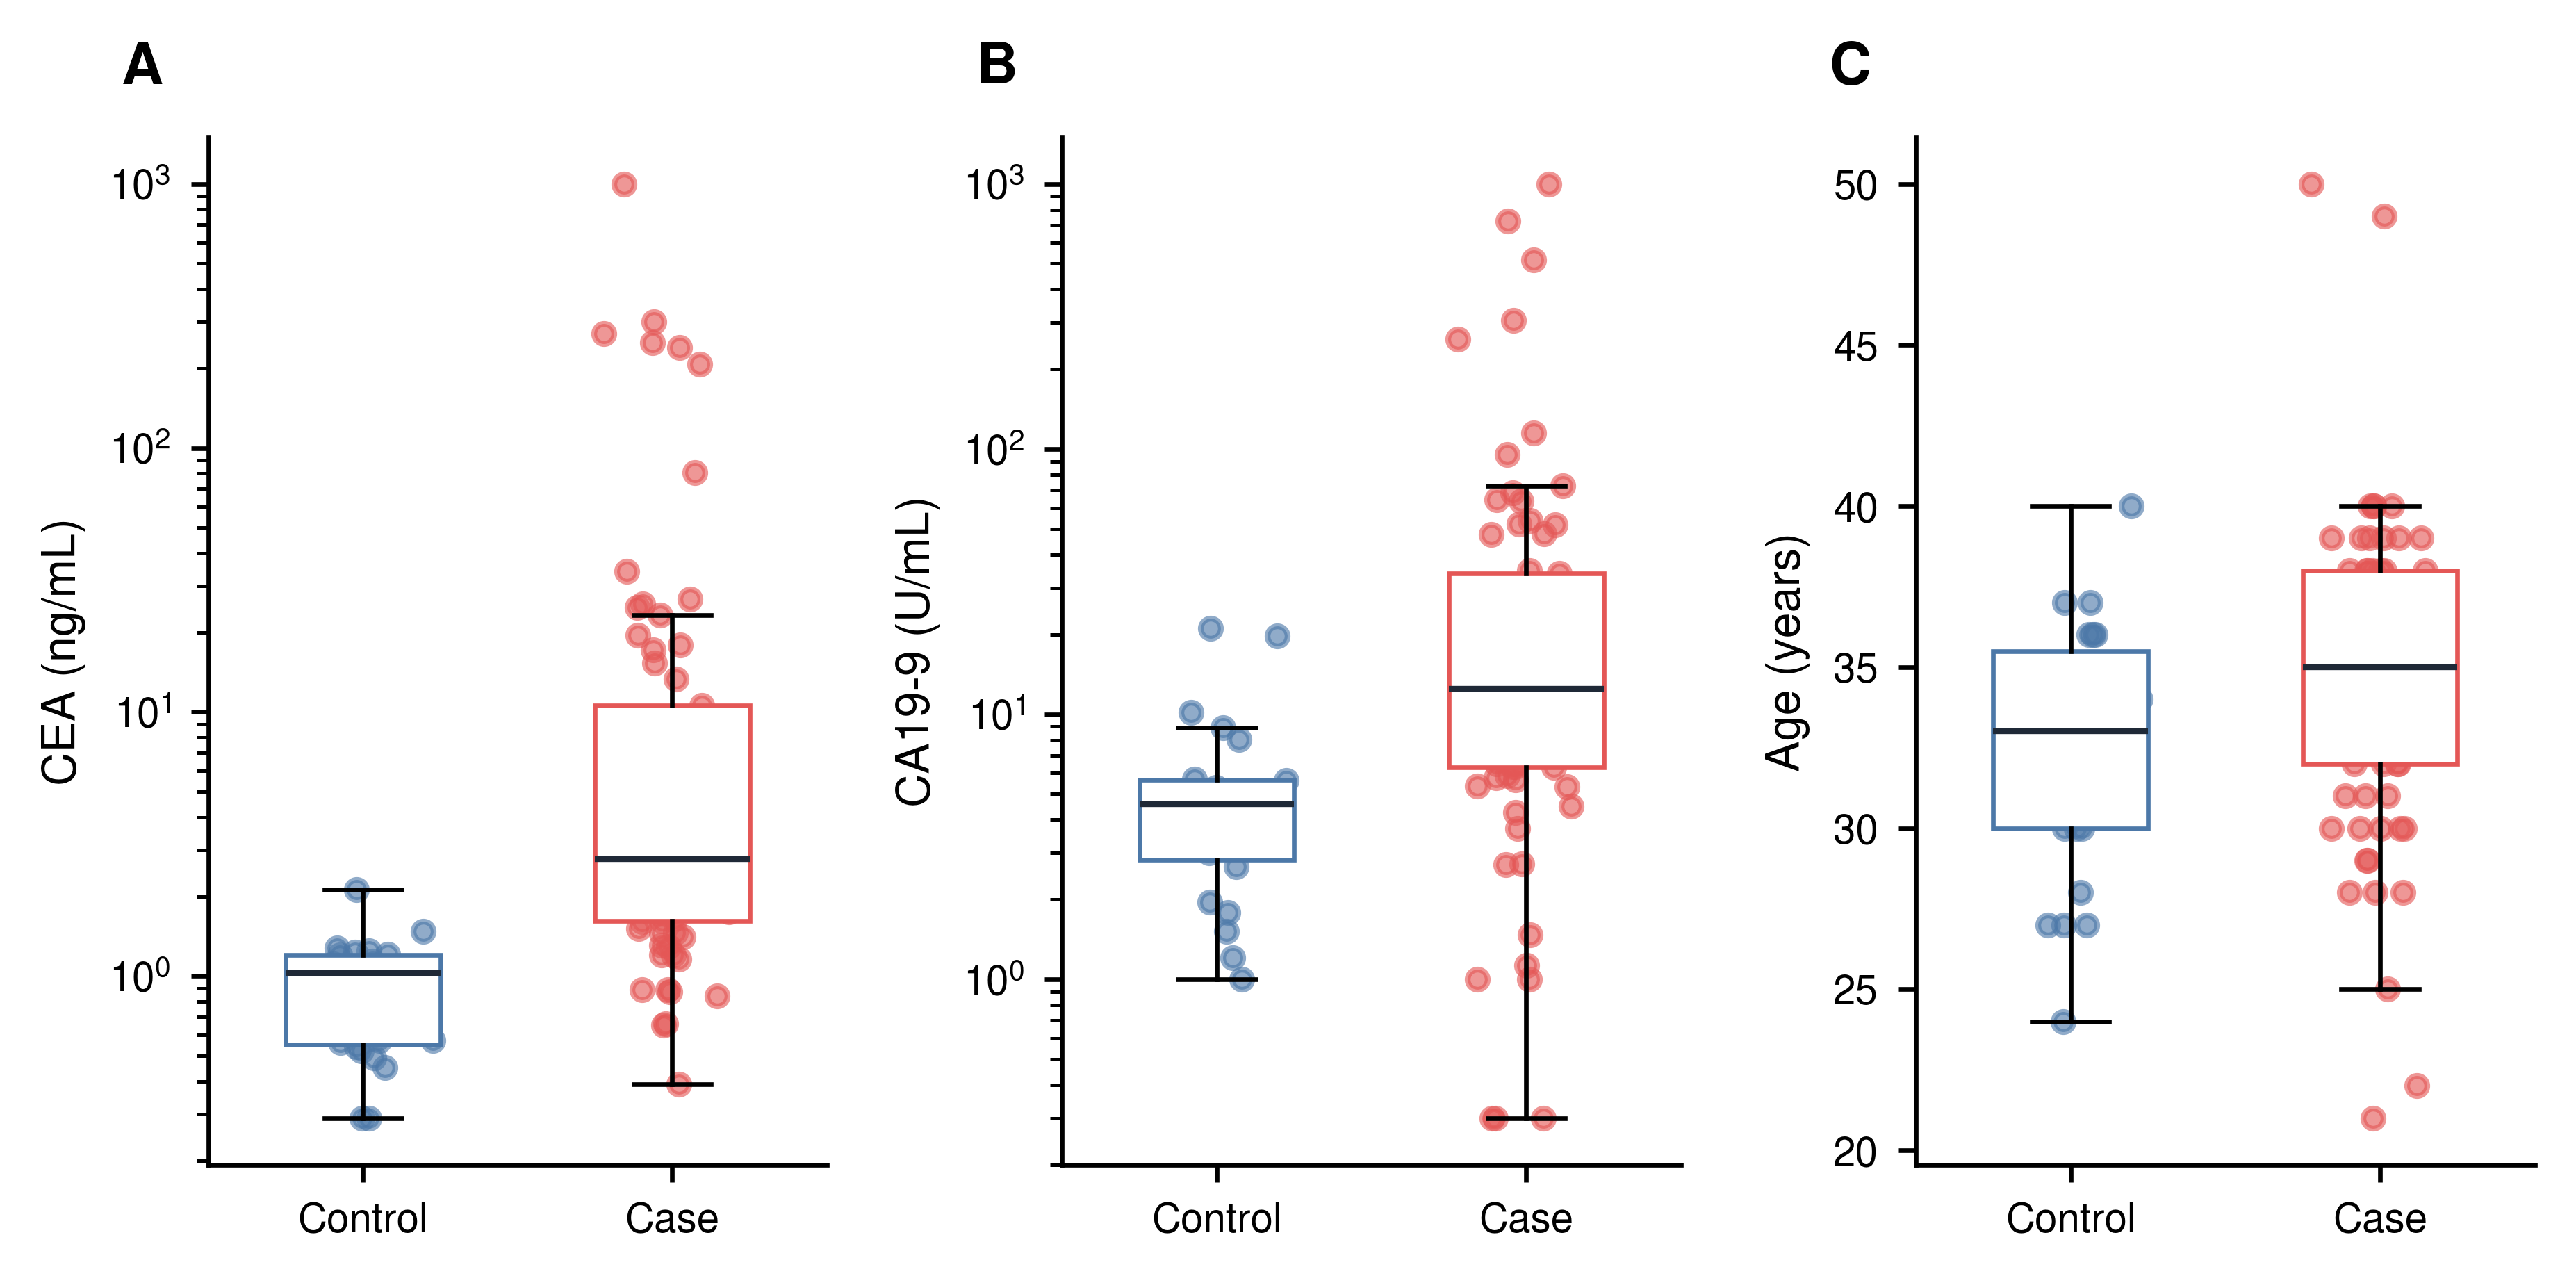
易算生物体液蛋白组诊断生物标志物分析示例。
常规指标与年龄的箱线图显示临床参照模型所使用的组间信息,散点显示各组内部的分布及重叠。蛋白模型与联合模型的比较保留这些变量,从而评价新增蛋白是否改变同一批患者的预测评分和分类表现。
图4 临床变量调整后的单蛋白关联
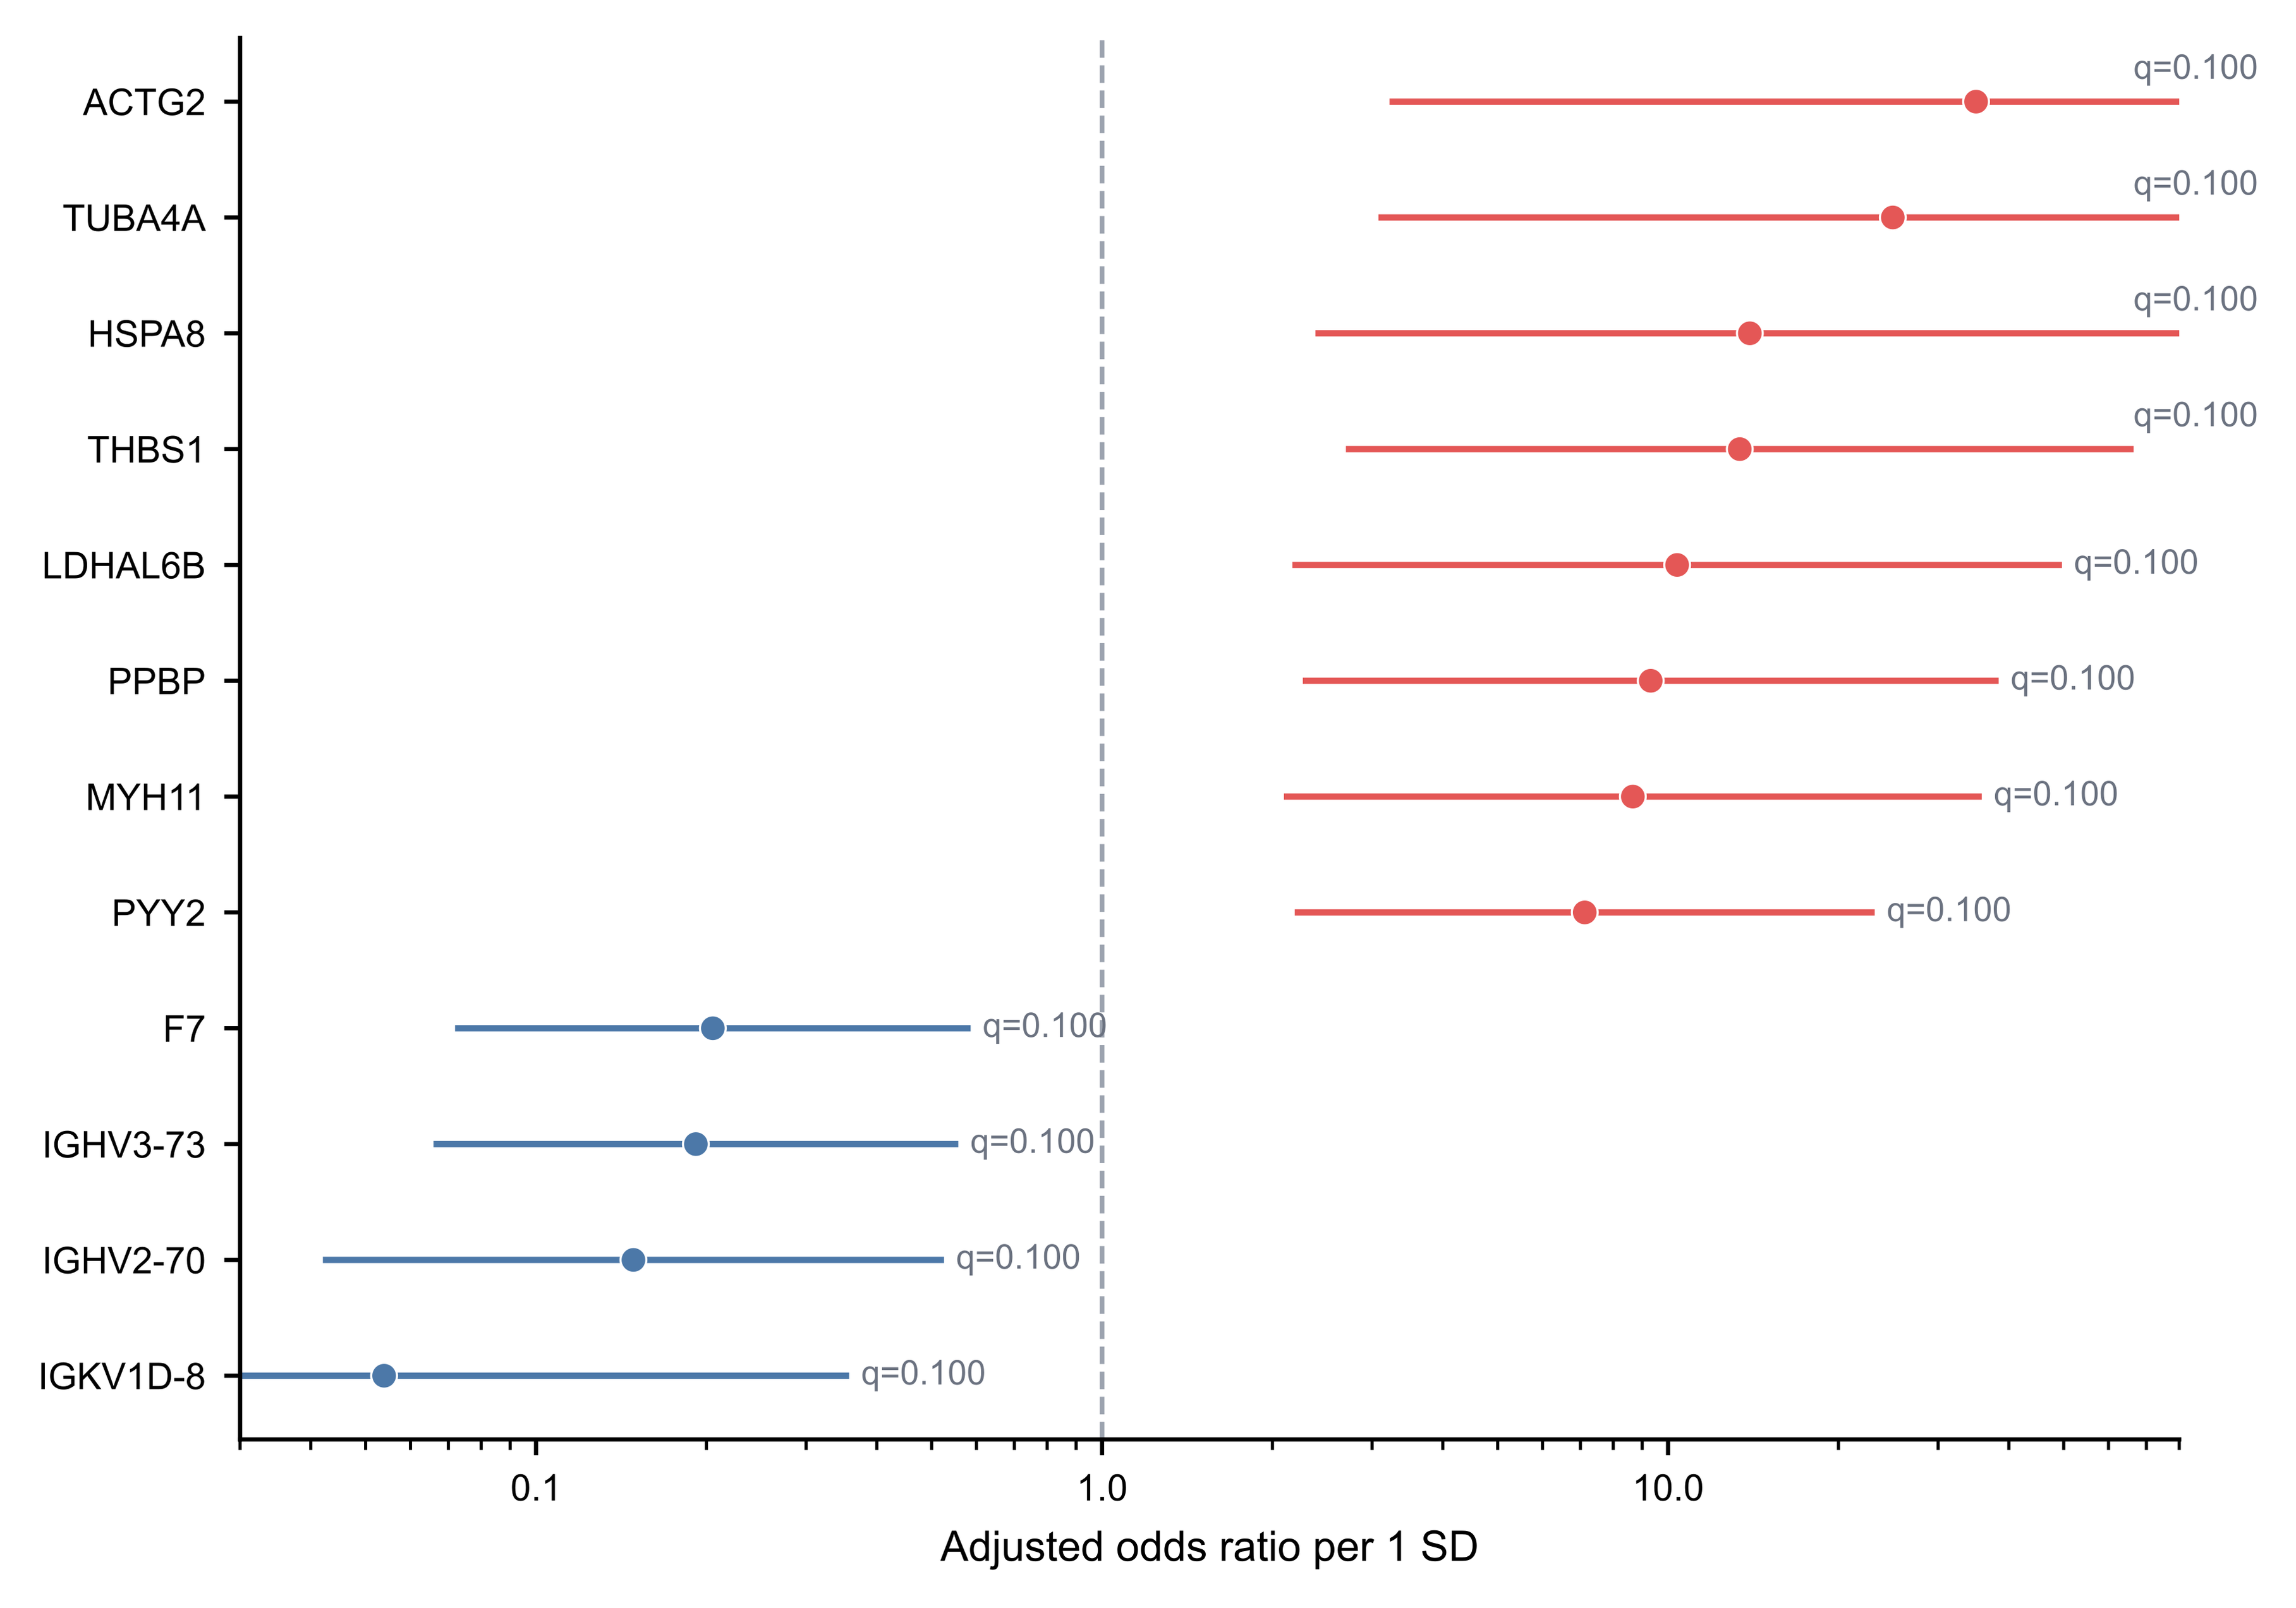
易算生物体液蛋白组诊断生物标志物分析示例。
点的位置表示临床变量调整后的关联方向与大小,横线长度表示估计精度。每个蛋白的效应均对应模型中相同的协变量条件;与调整前结果对照时,效应变化说明蛋白关联与这些临床变量之间的关系。
图5 单个候选蛋白的描述性ROC
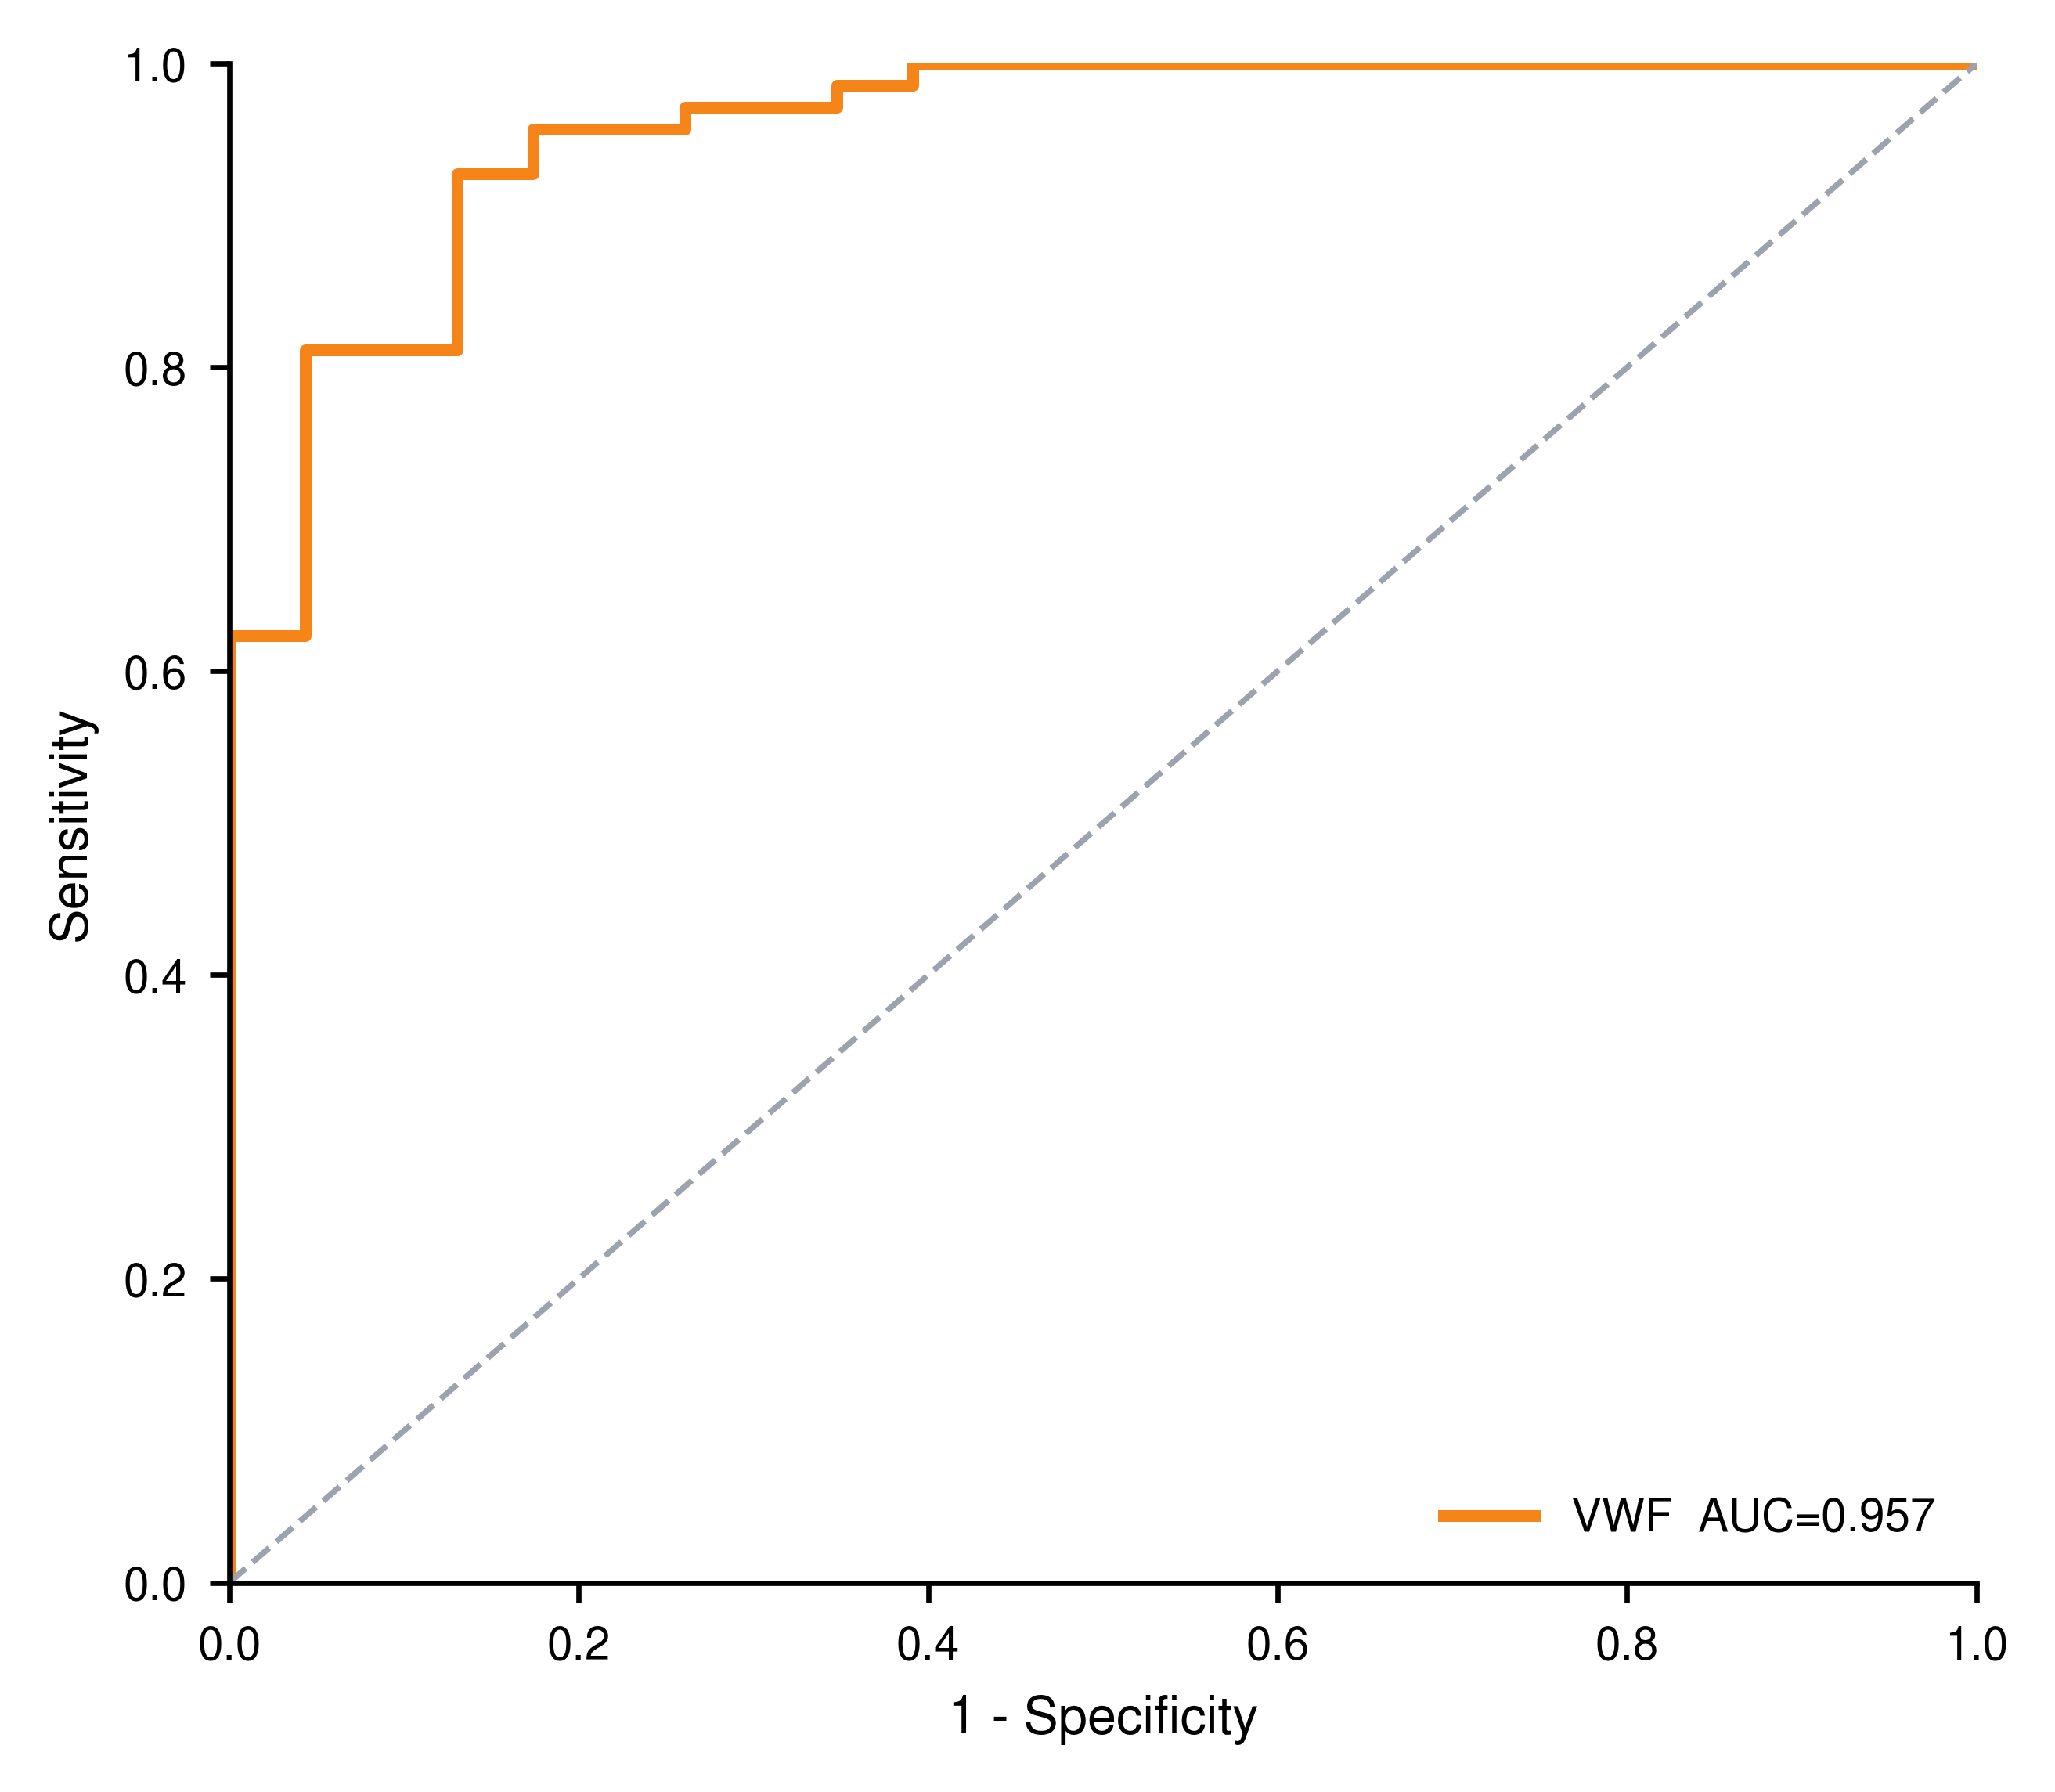
易算生物体液蛋白组诊断生物标志物分析示例。
不同丰度截点对应不同的灵敏度与特异度,曲线展示该候选在发现数据中的排序表现。这里的单蛋白结果来自同一开发子集的筛选与描述性评价;多蛋白模型的折外结果另行展示,两者分别对应候选发现和重复建模评价。
图6 常规 蛋白与联合模型的折外区分表现
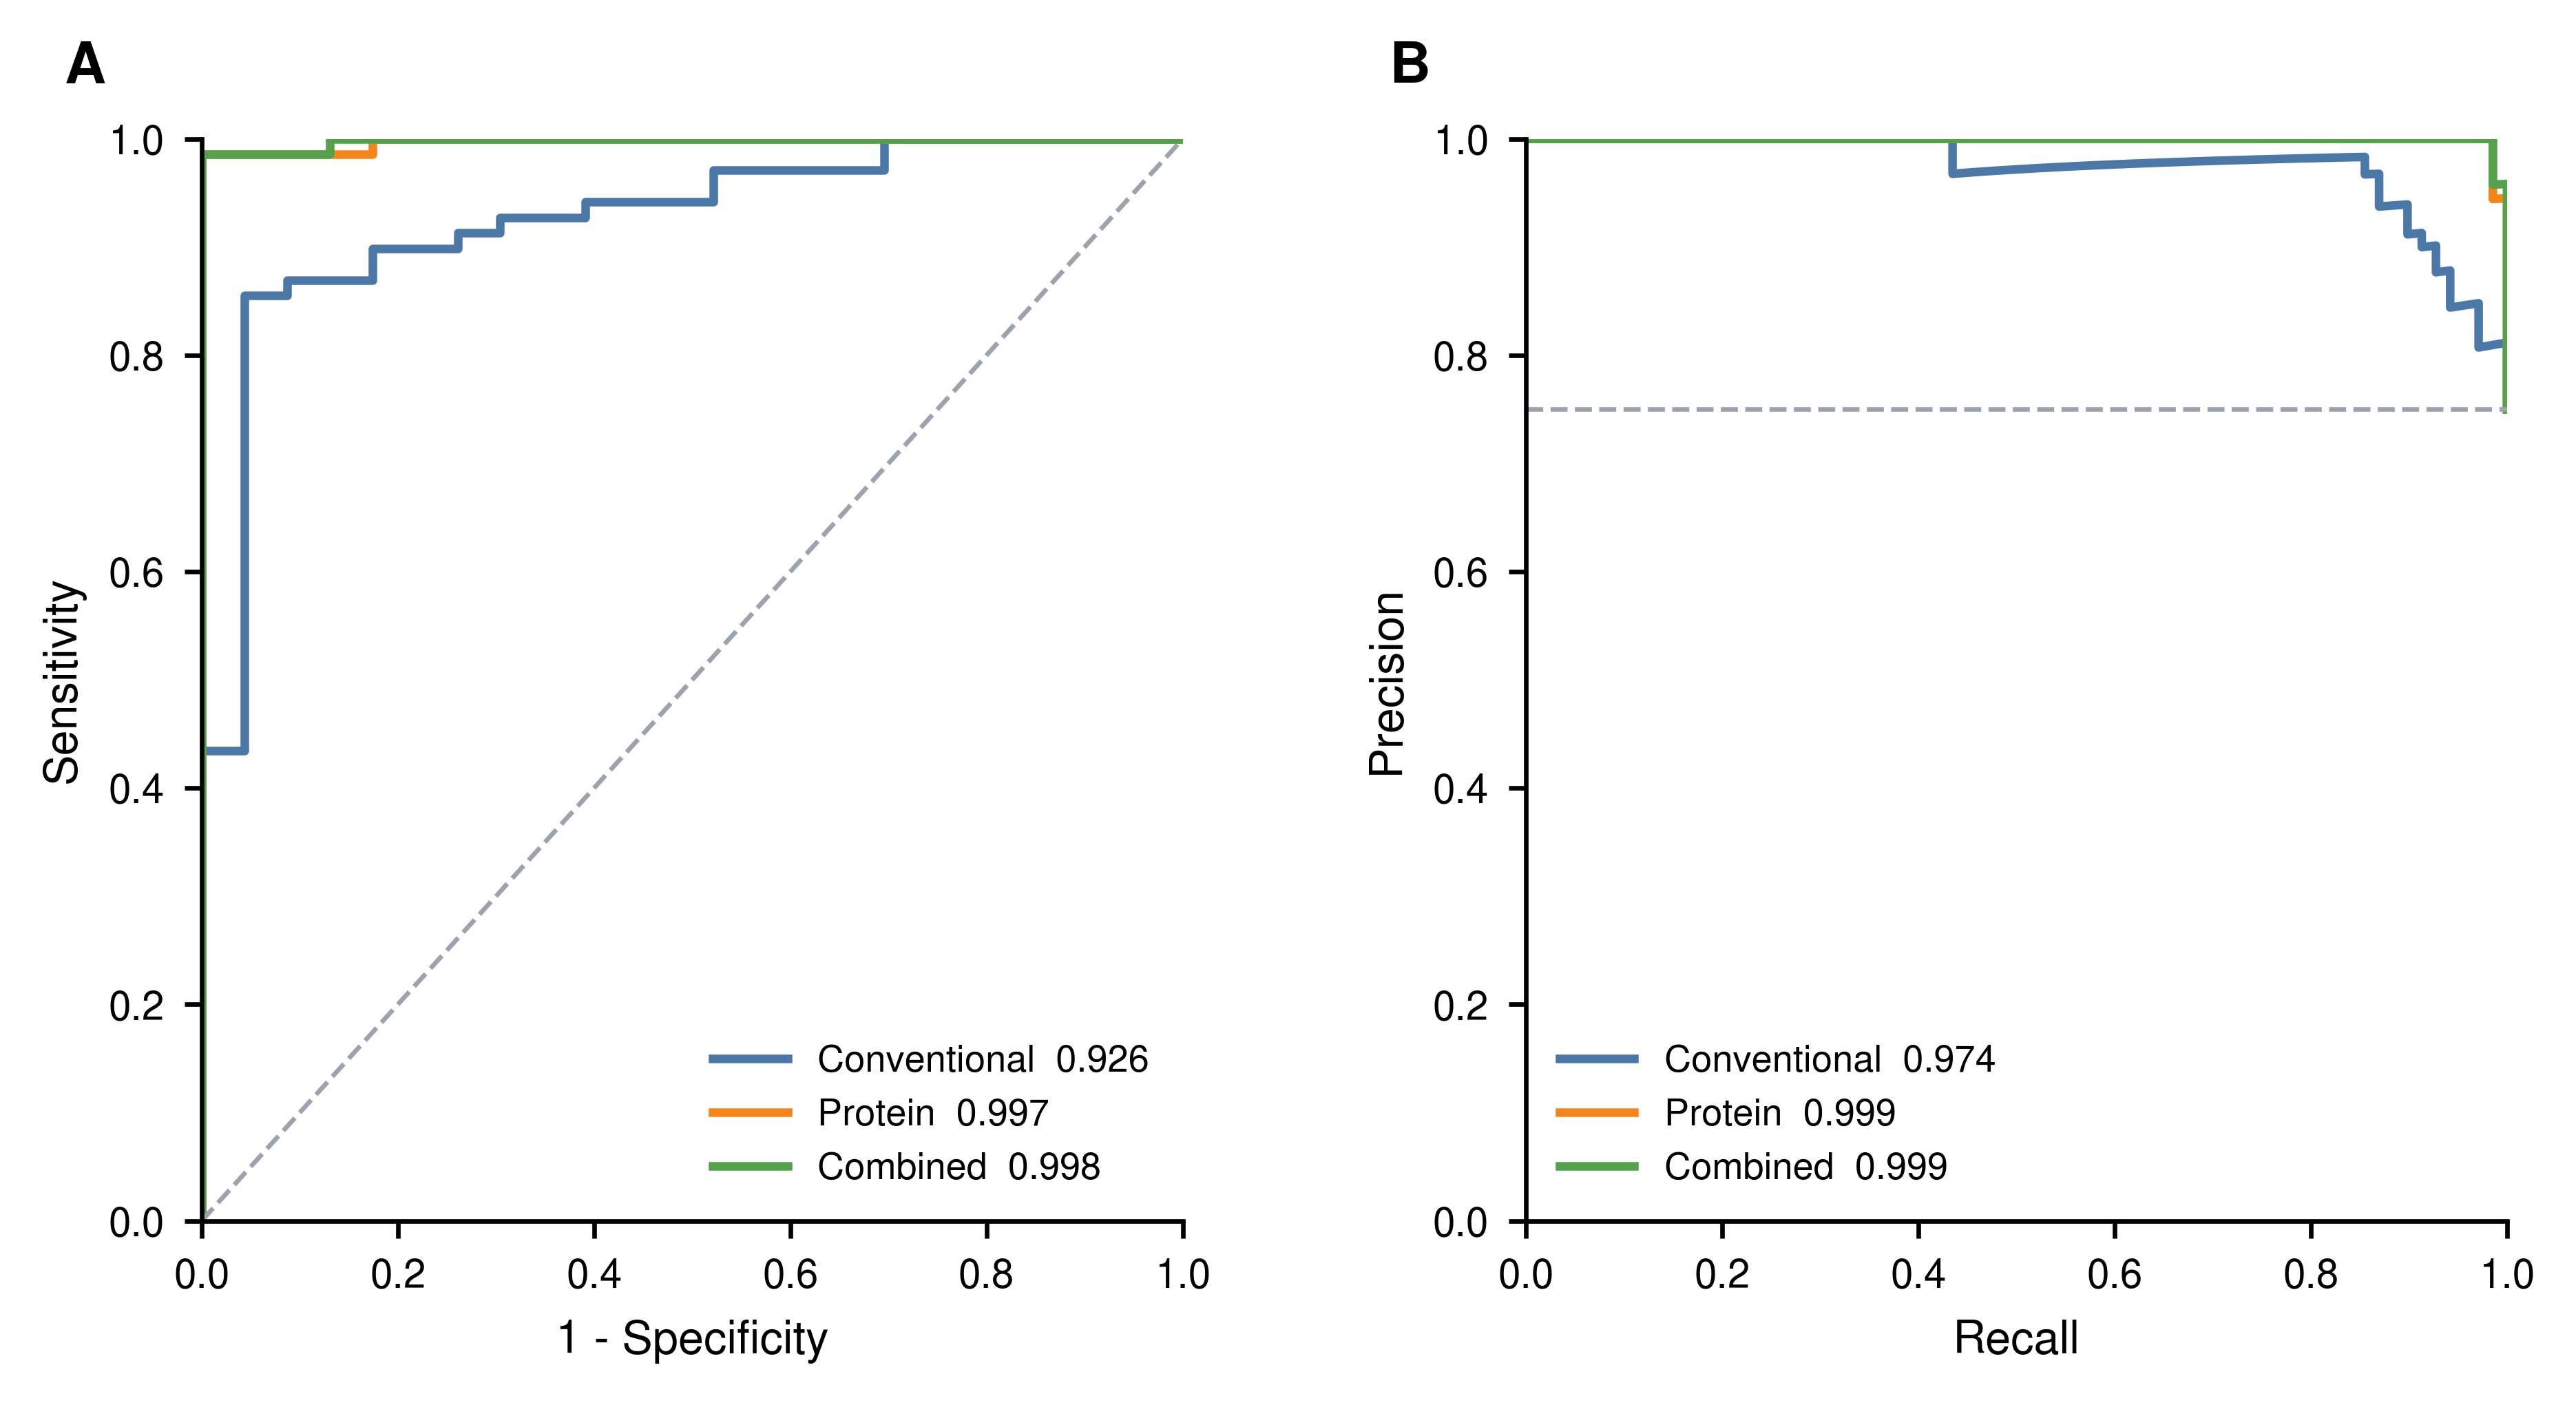
易算生物体液蛋白组诊断生物标志物分析示例。
三类模型对同一批患者生成折外预测,ROC比较灵敏度与特异度,精确率—召回率曲线显示当前病例比例下的阳性预测表现。曲线差异对应该开发队列及相同评价条件下,临床与蛋白信息的分类贡献。
图7 早期病例子集的折外ROC
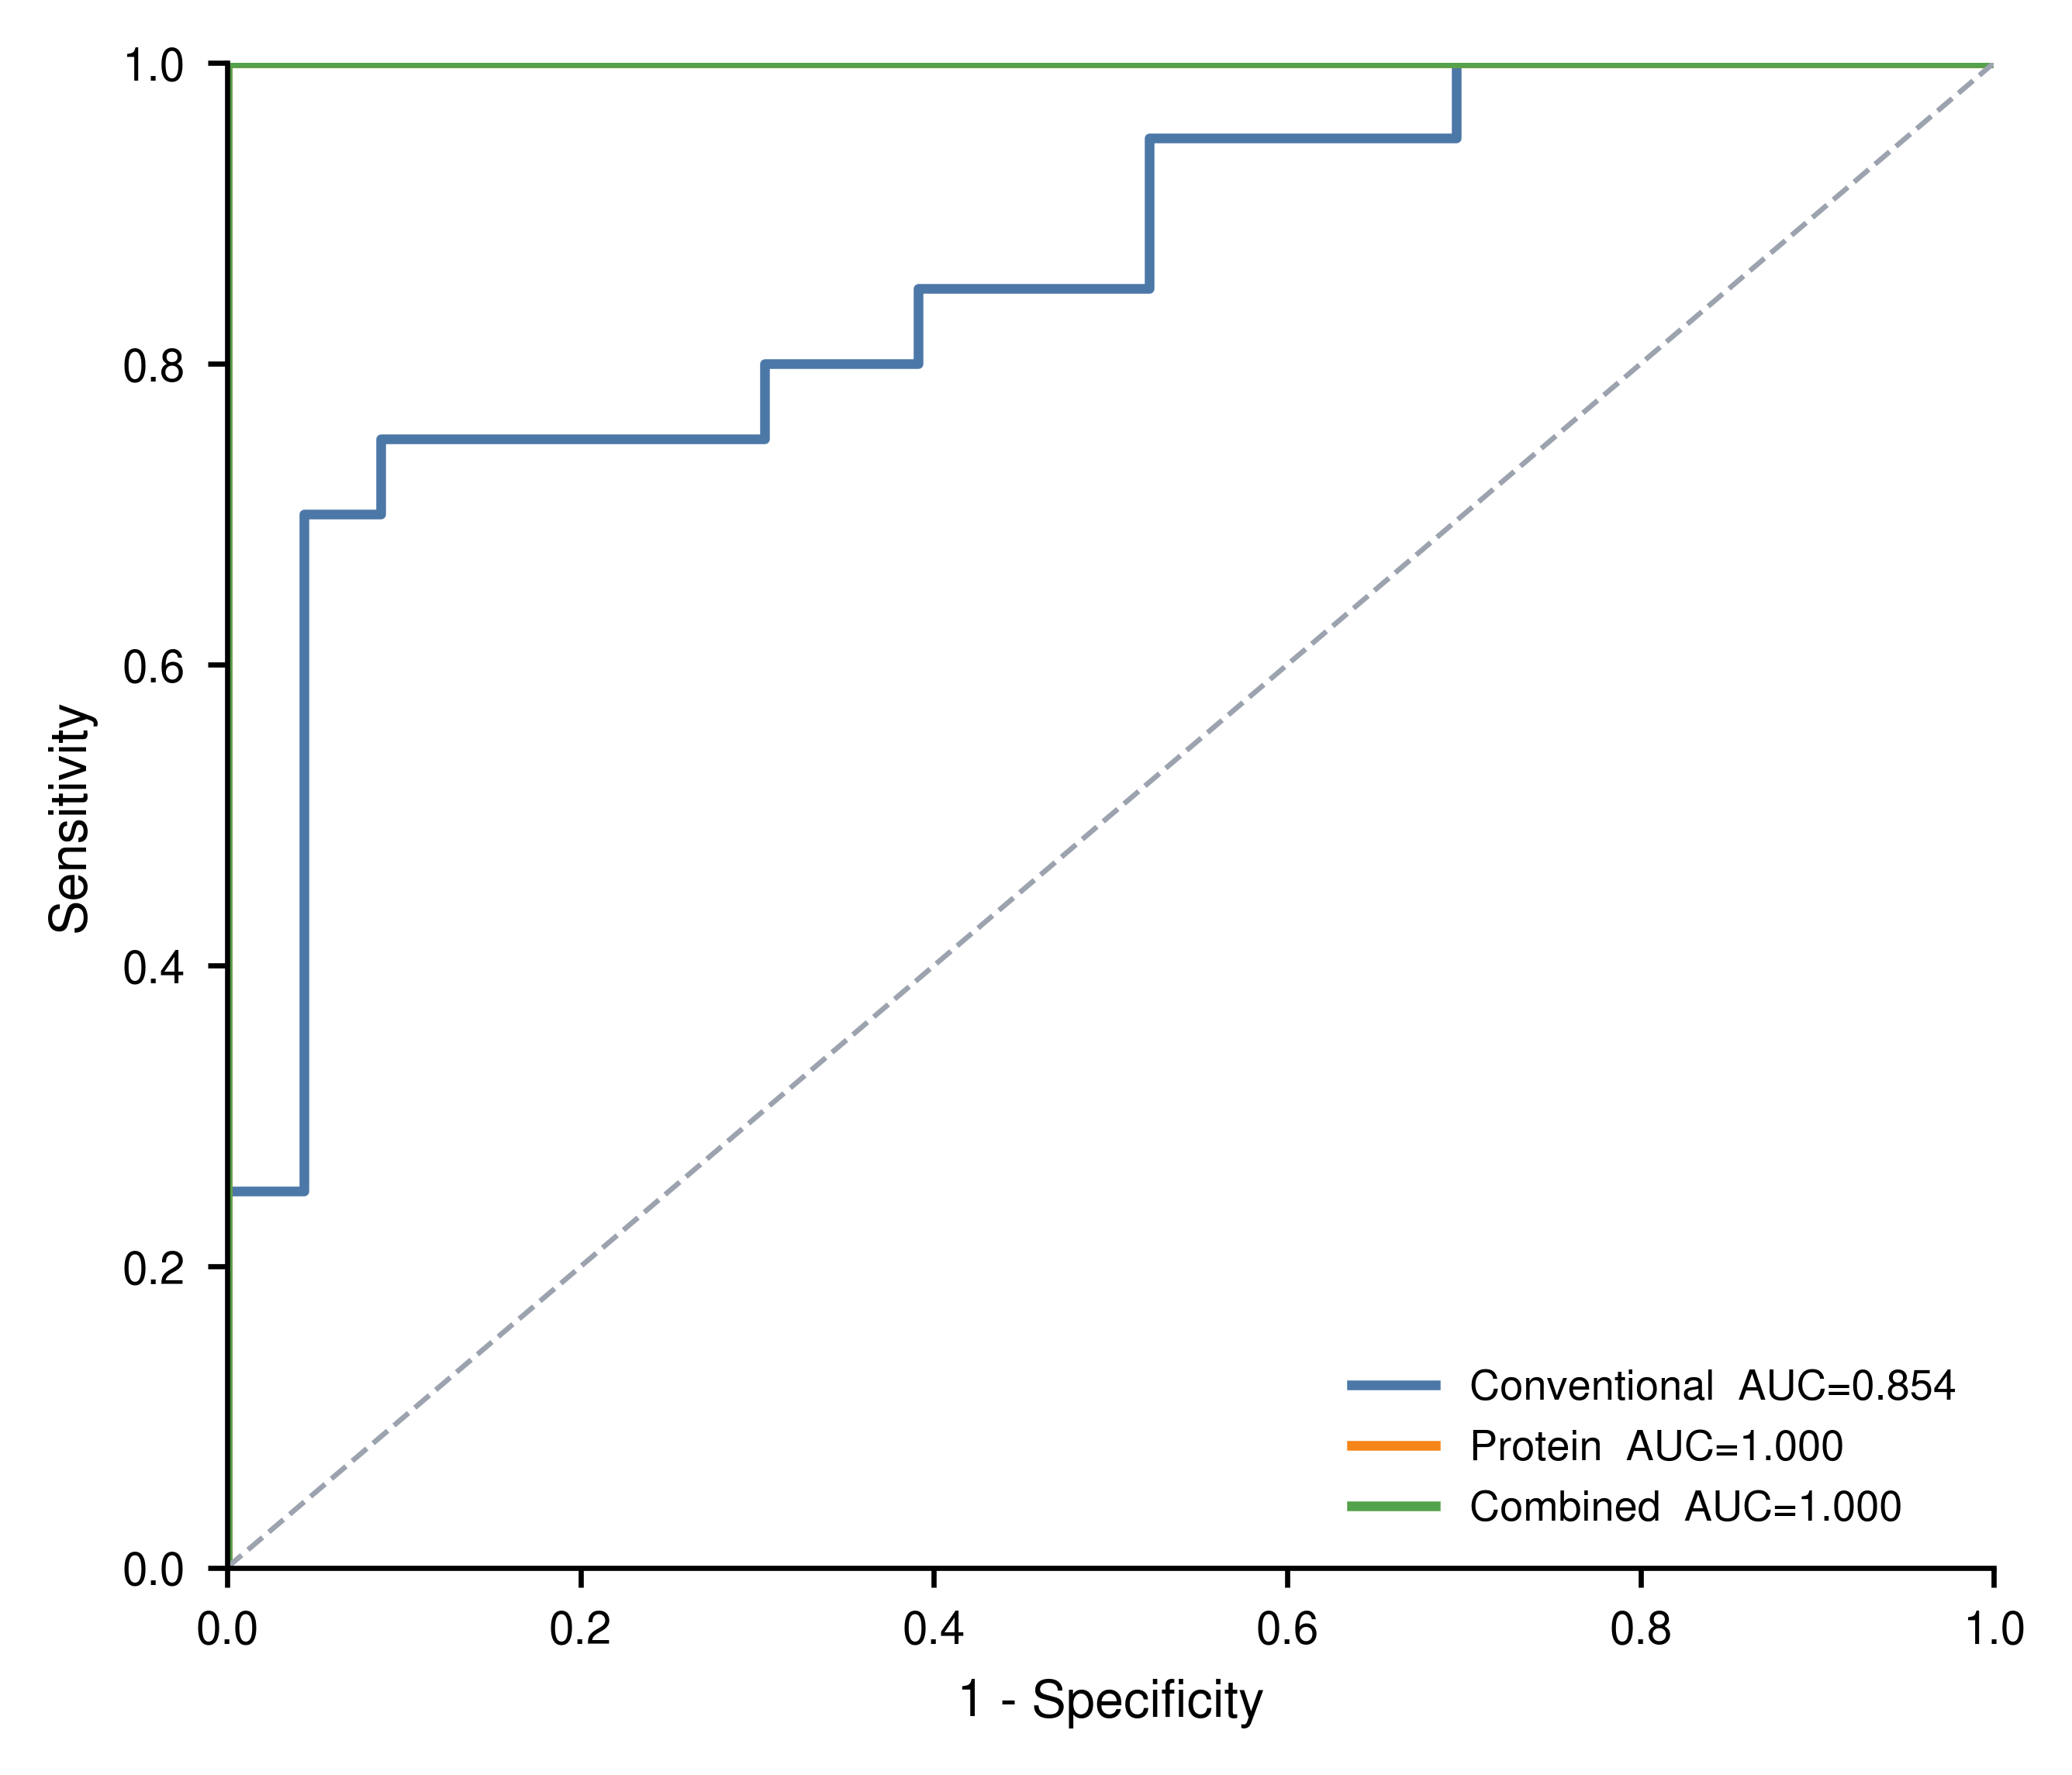
易算生物体液蛋白组诊断生物标志物分析示例。
早期病例与对照沿用主模型为各患者生成的折外评分,比较对象限于当前开发队列的相应子集。曲线与总体ROC之间的差异反映纳入病例阶段改变后的排序表现,分期评分分布则显示这种变化由怎样的患者分数构成。
图8 病例与对照的折外预测概率分布
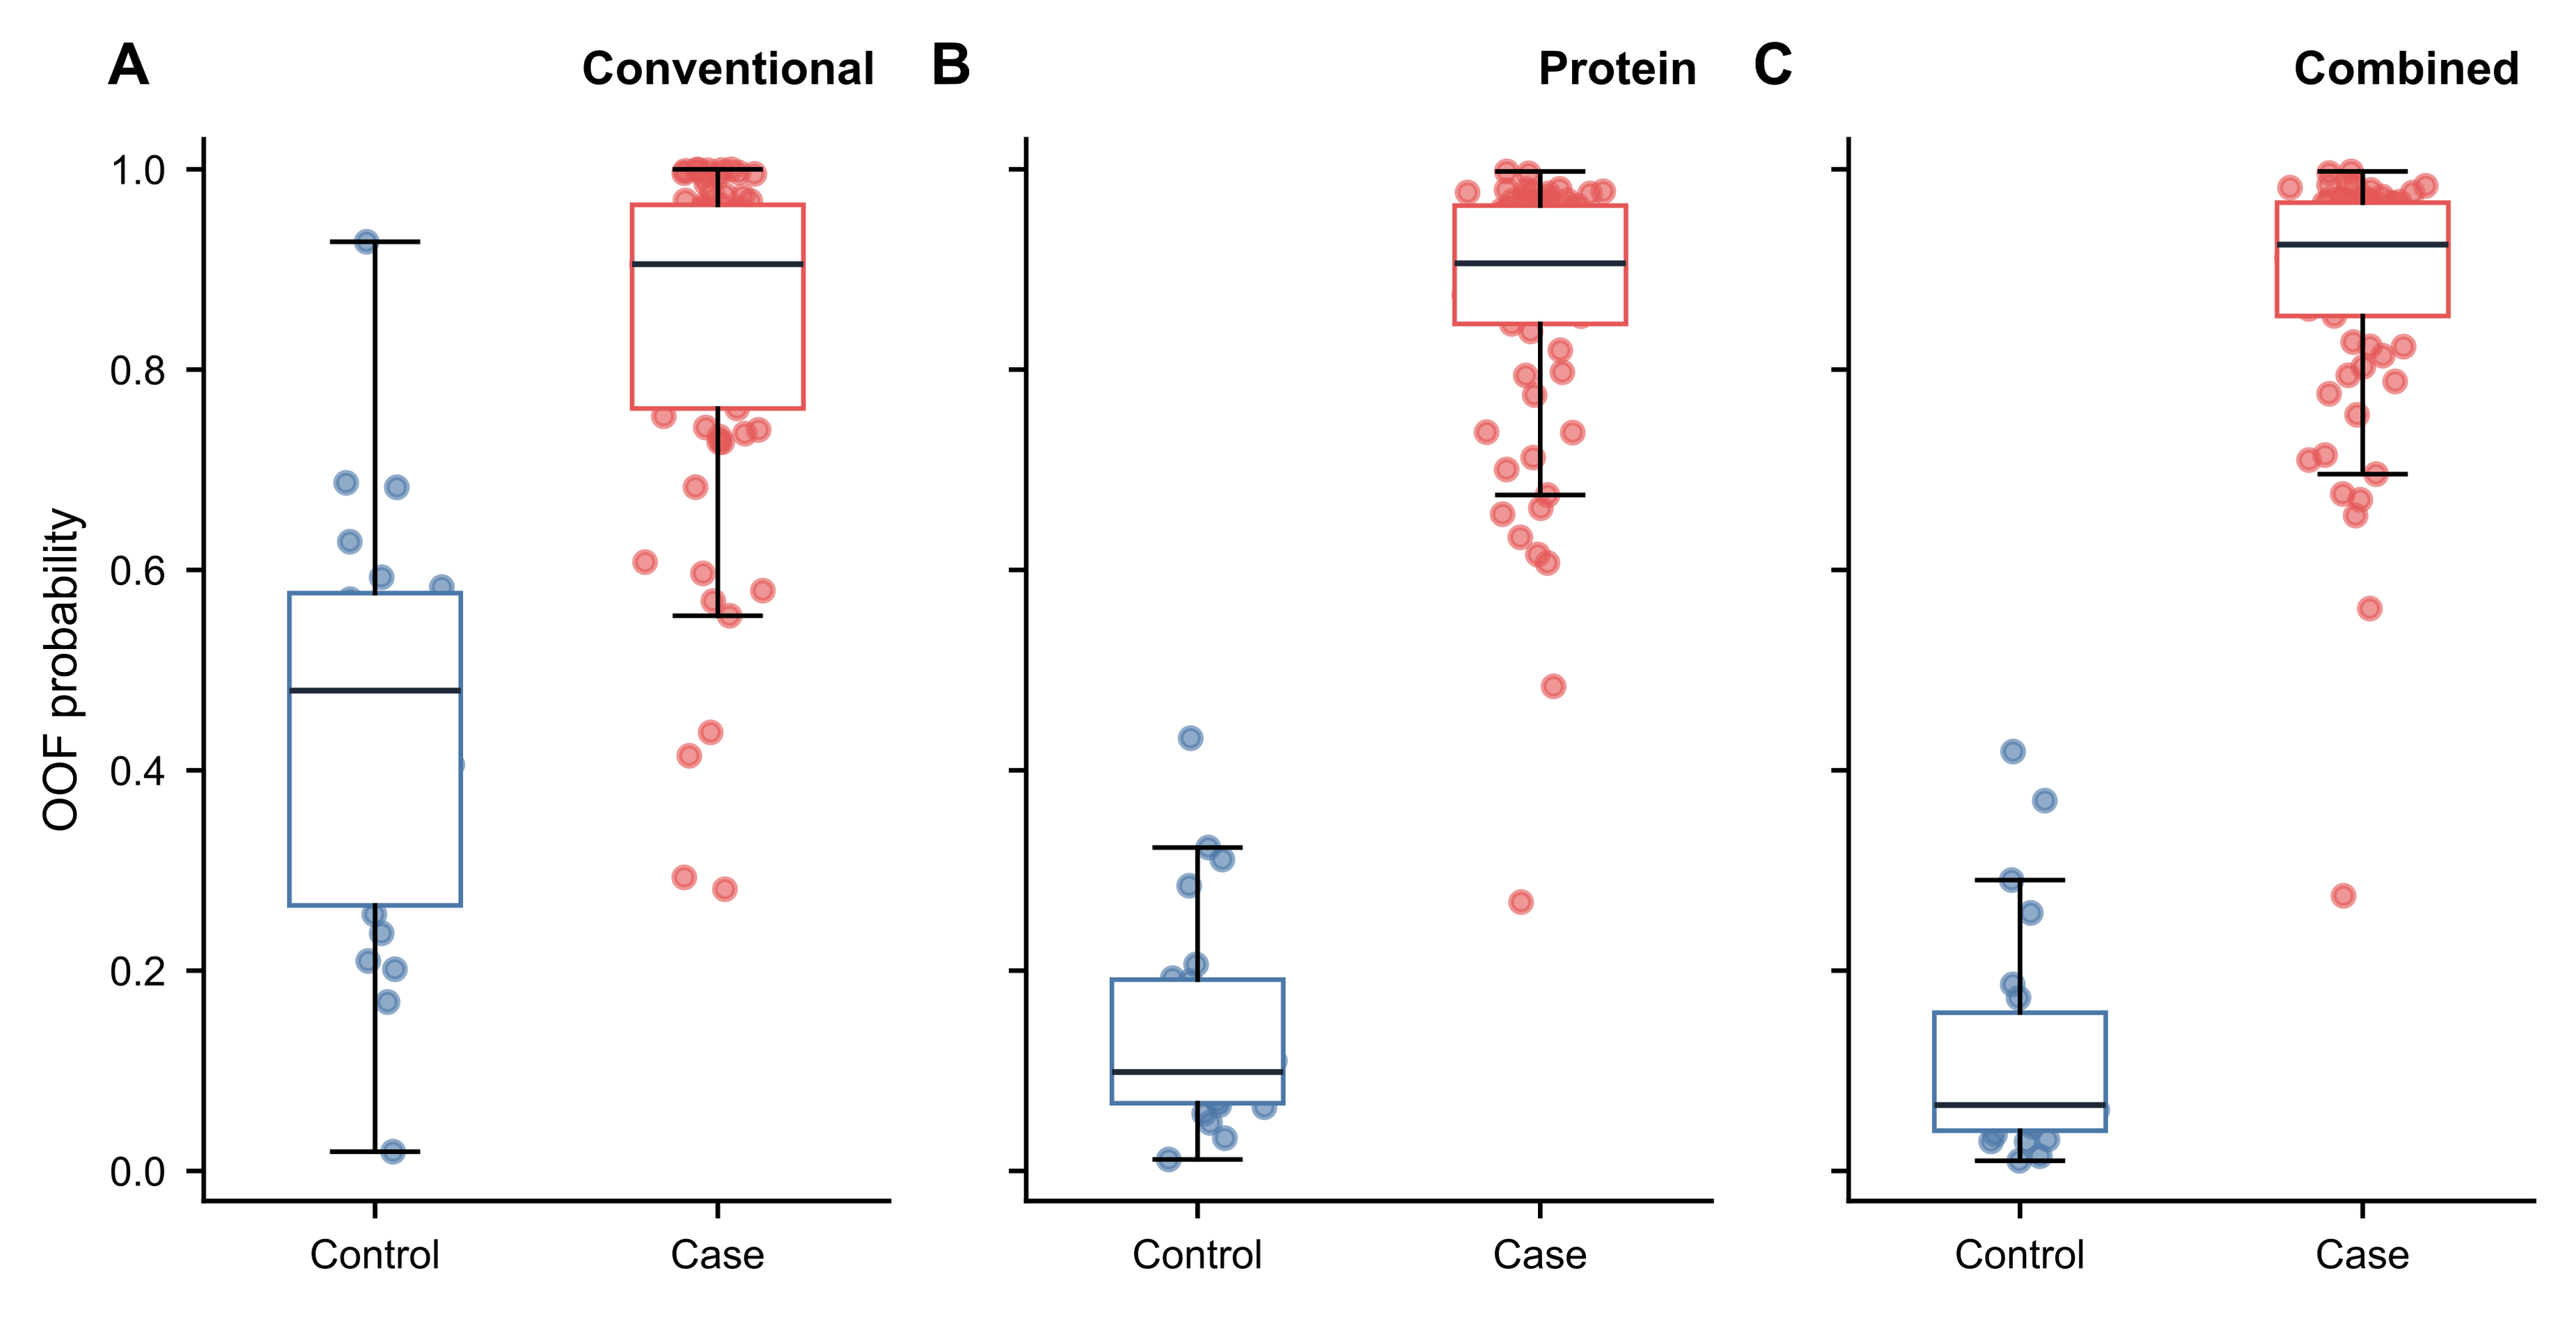
易算生物体液蛋白组诊断生物标志物分析示例。
病例与对照的每个点均对应一位受试者的折外概率,箱线图概括两组评分分布。阈值划分后,低评分病例与高评分对照分别落在可能漏检和误报的一侧,显示整体区分指标背后的个体重叠及预测偏差。
图9 开发队列中的预测概率校准
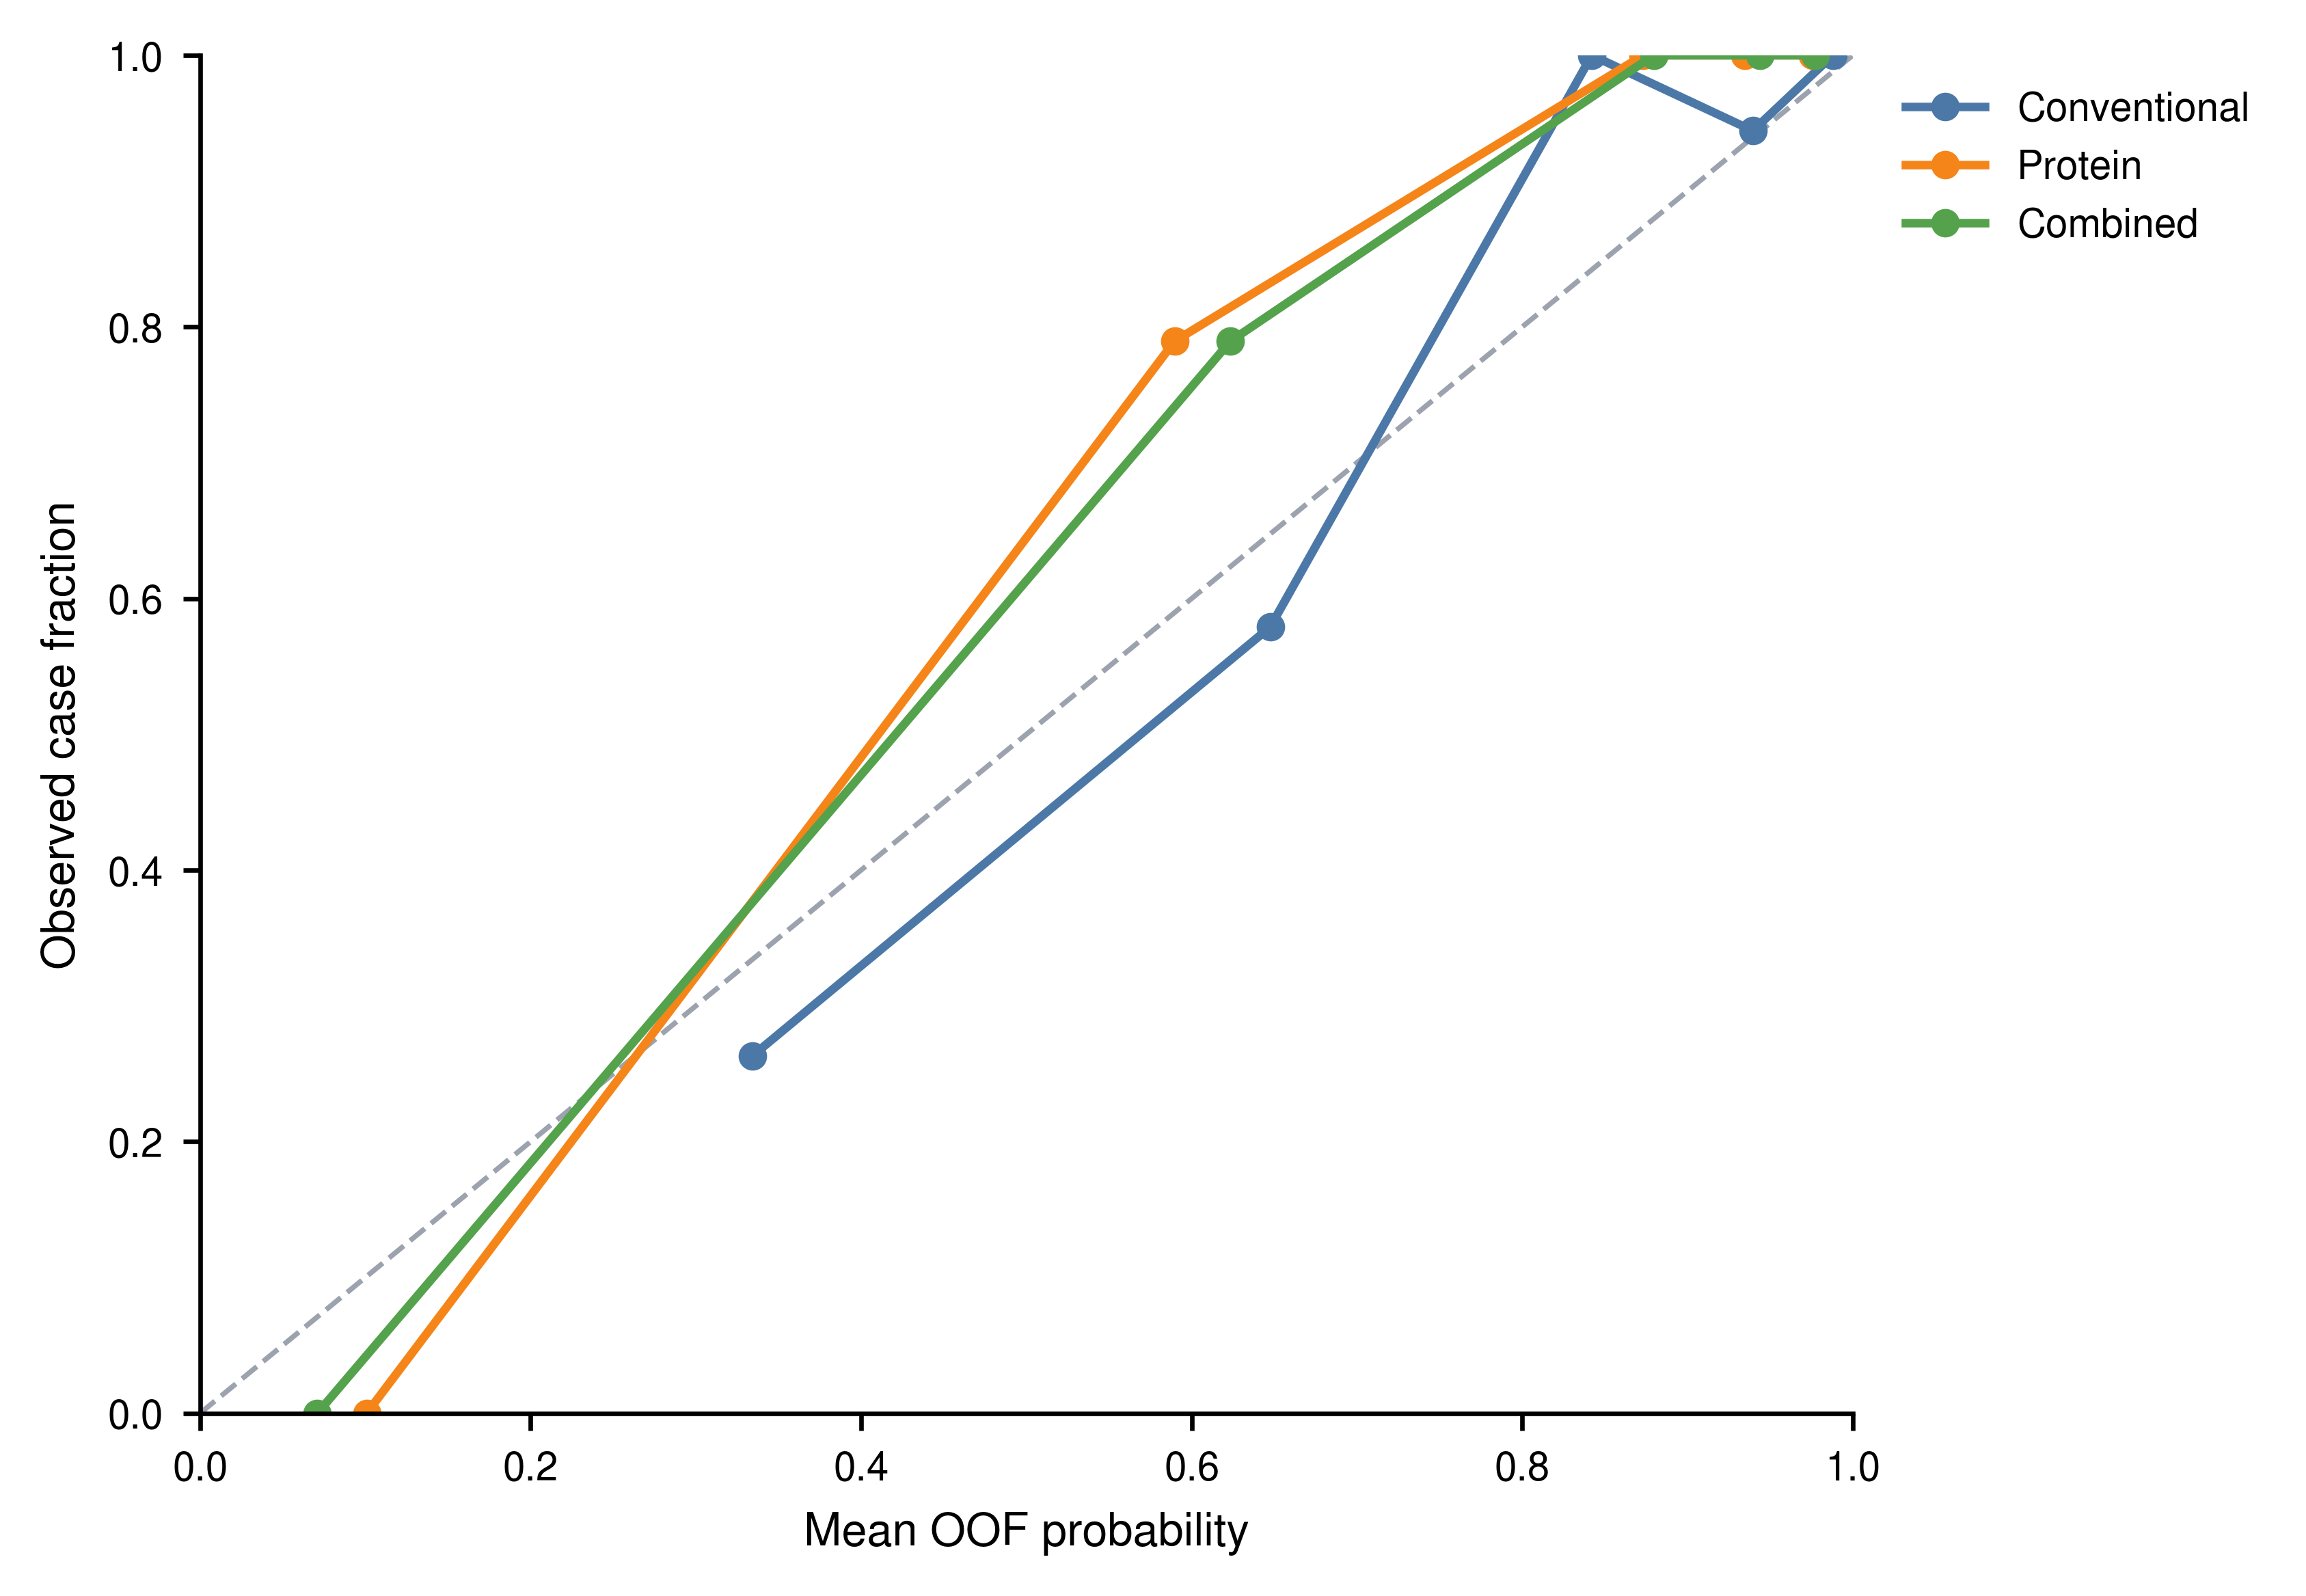
易算生物体液蛋白组诊断生物标志物分析示例。
模型概率与观察病例比例越接近,曲线越靠近理想一致关系;偏离方向显示概率在相应区间偏高或偏低。该比较对应当前抽样人群的病例比例。排序由ROC描述,概率数值是否匹配则由此处的校准结果评价。
图10 固定概率阈值下的分类指标
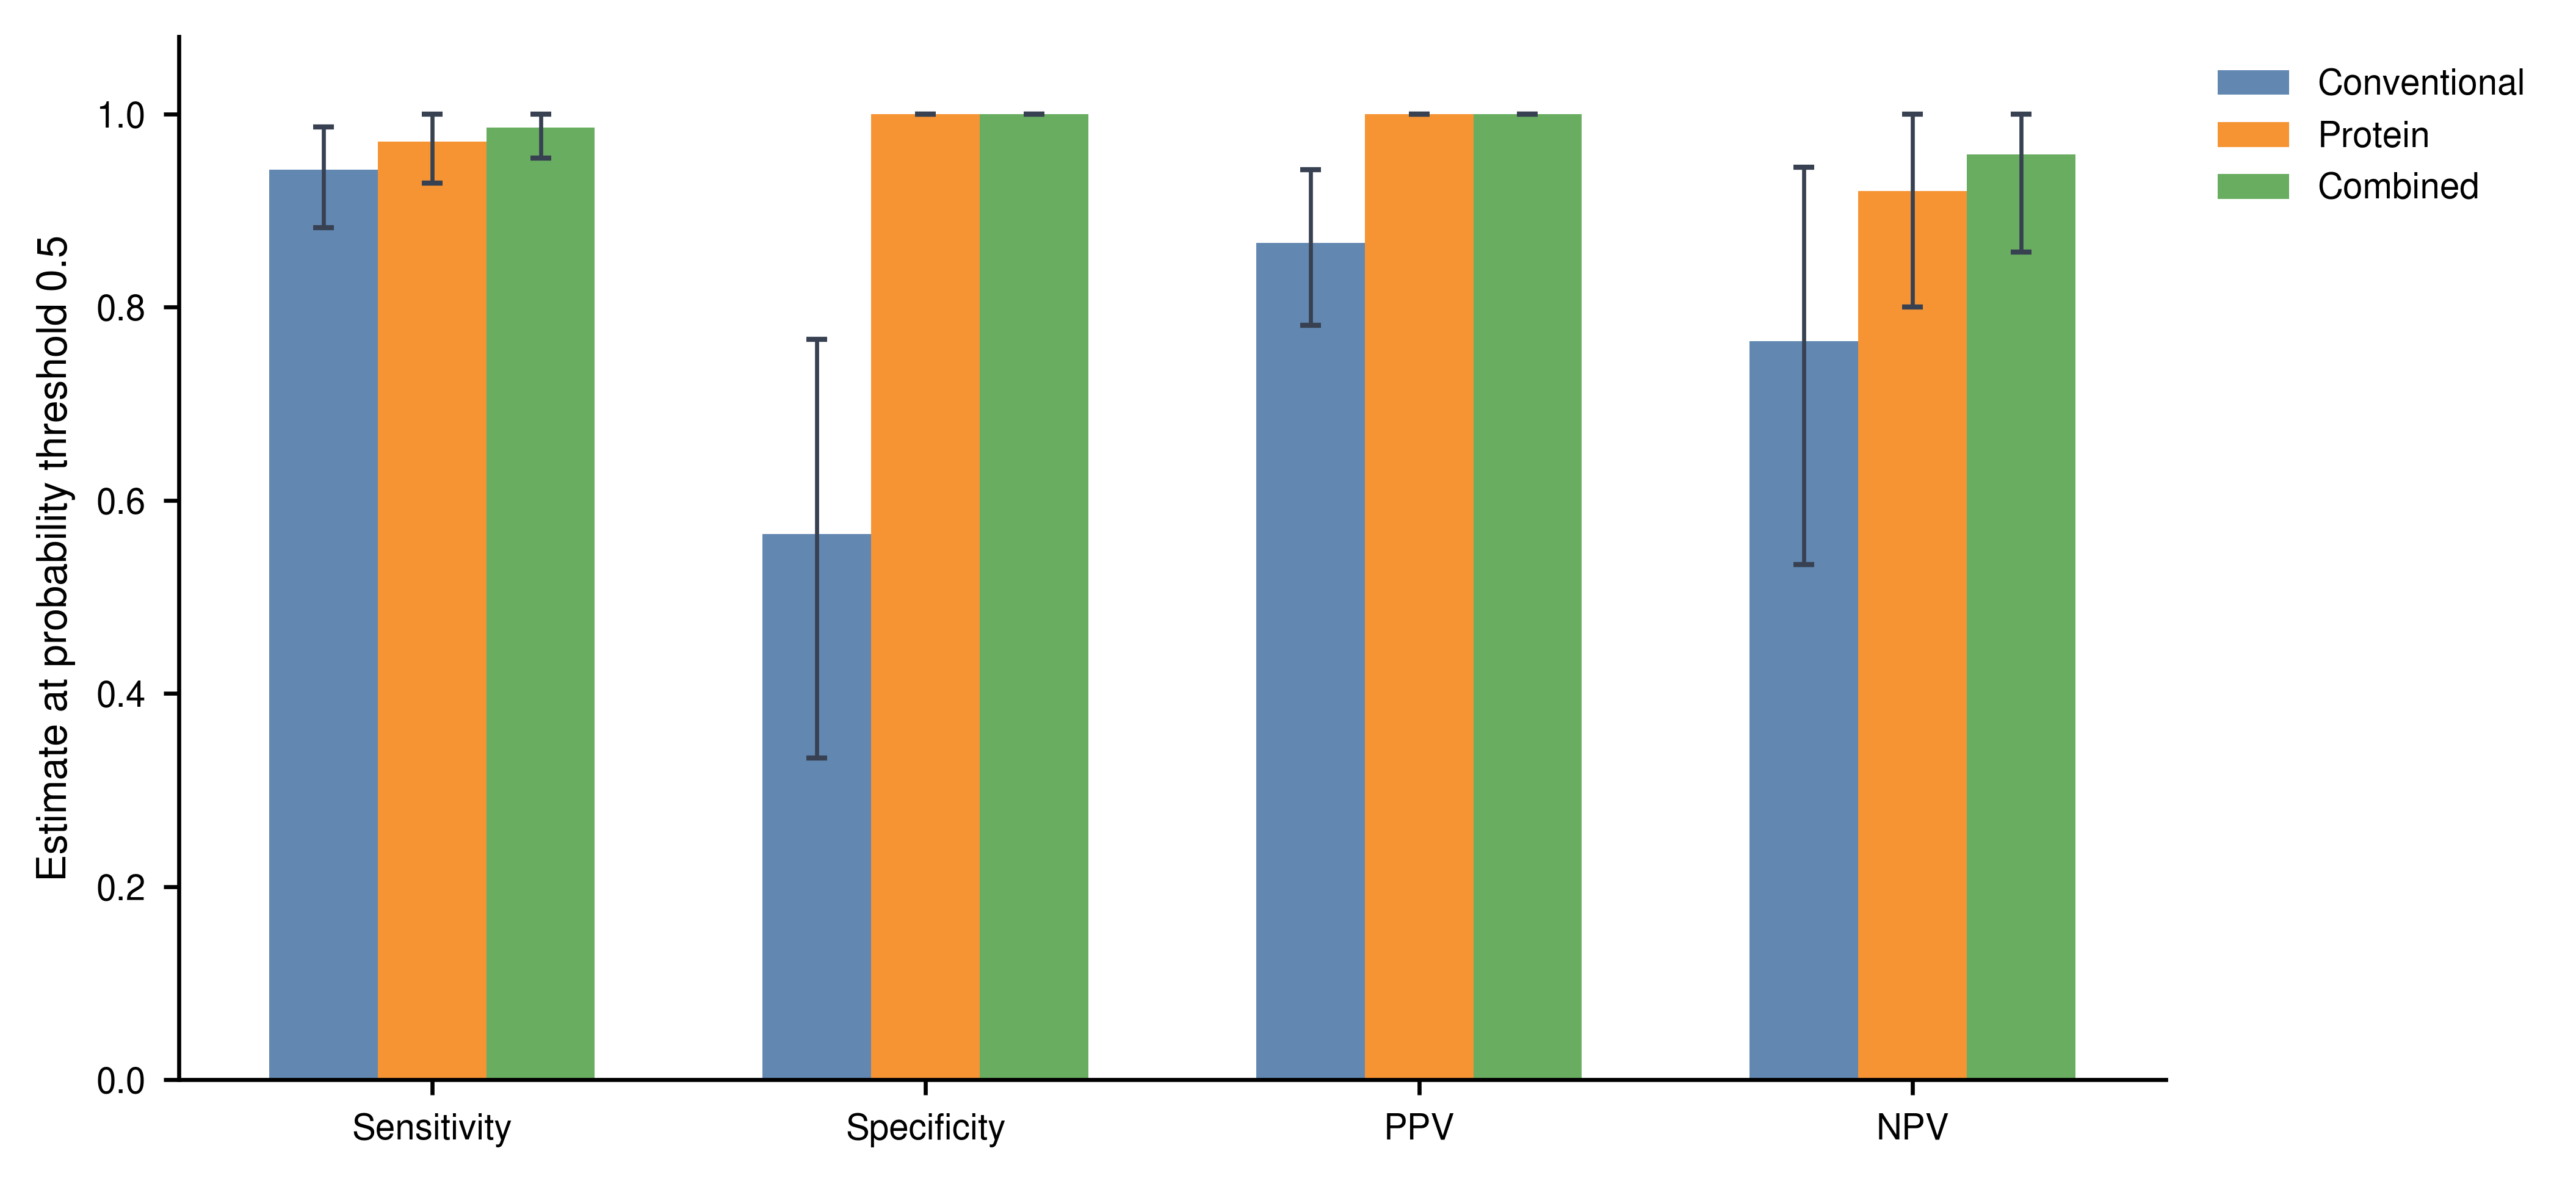
易算生物体液蛋白组诊断生物标志物分析示例。
固定阈值将连续概率转换为类别后,灵敏度和特异度分别衡量病例及对照的识别情况。阳性与阴性预测值描述预测类别中的实际组成,对应图示69例病例、23例对照的抽样比例;区间估计还显示各指标的精度。
图11 固定阈值下的病例与对照分类人数
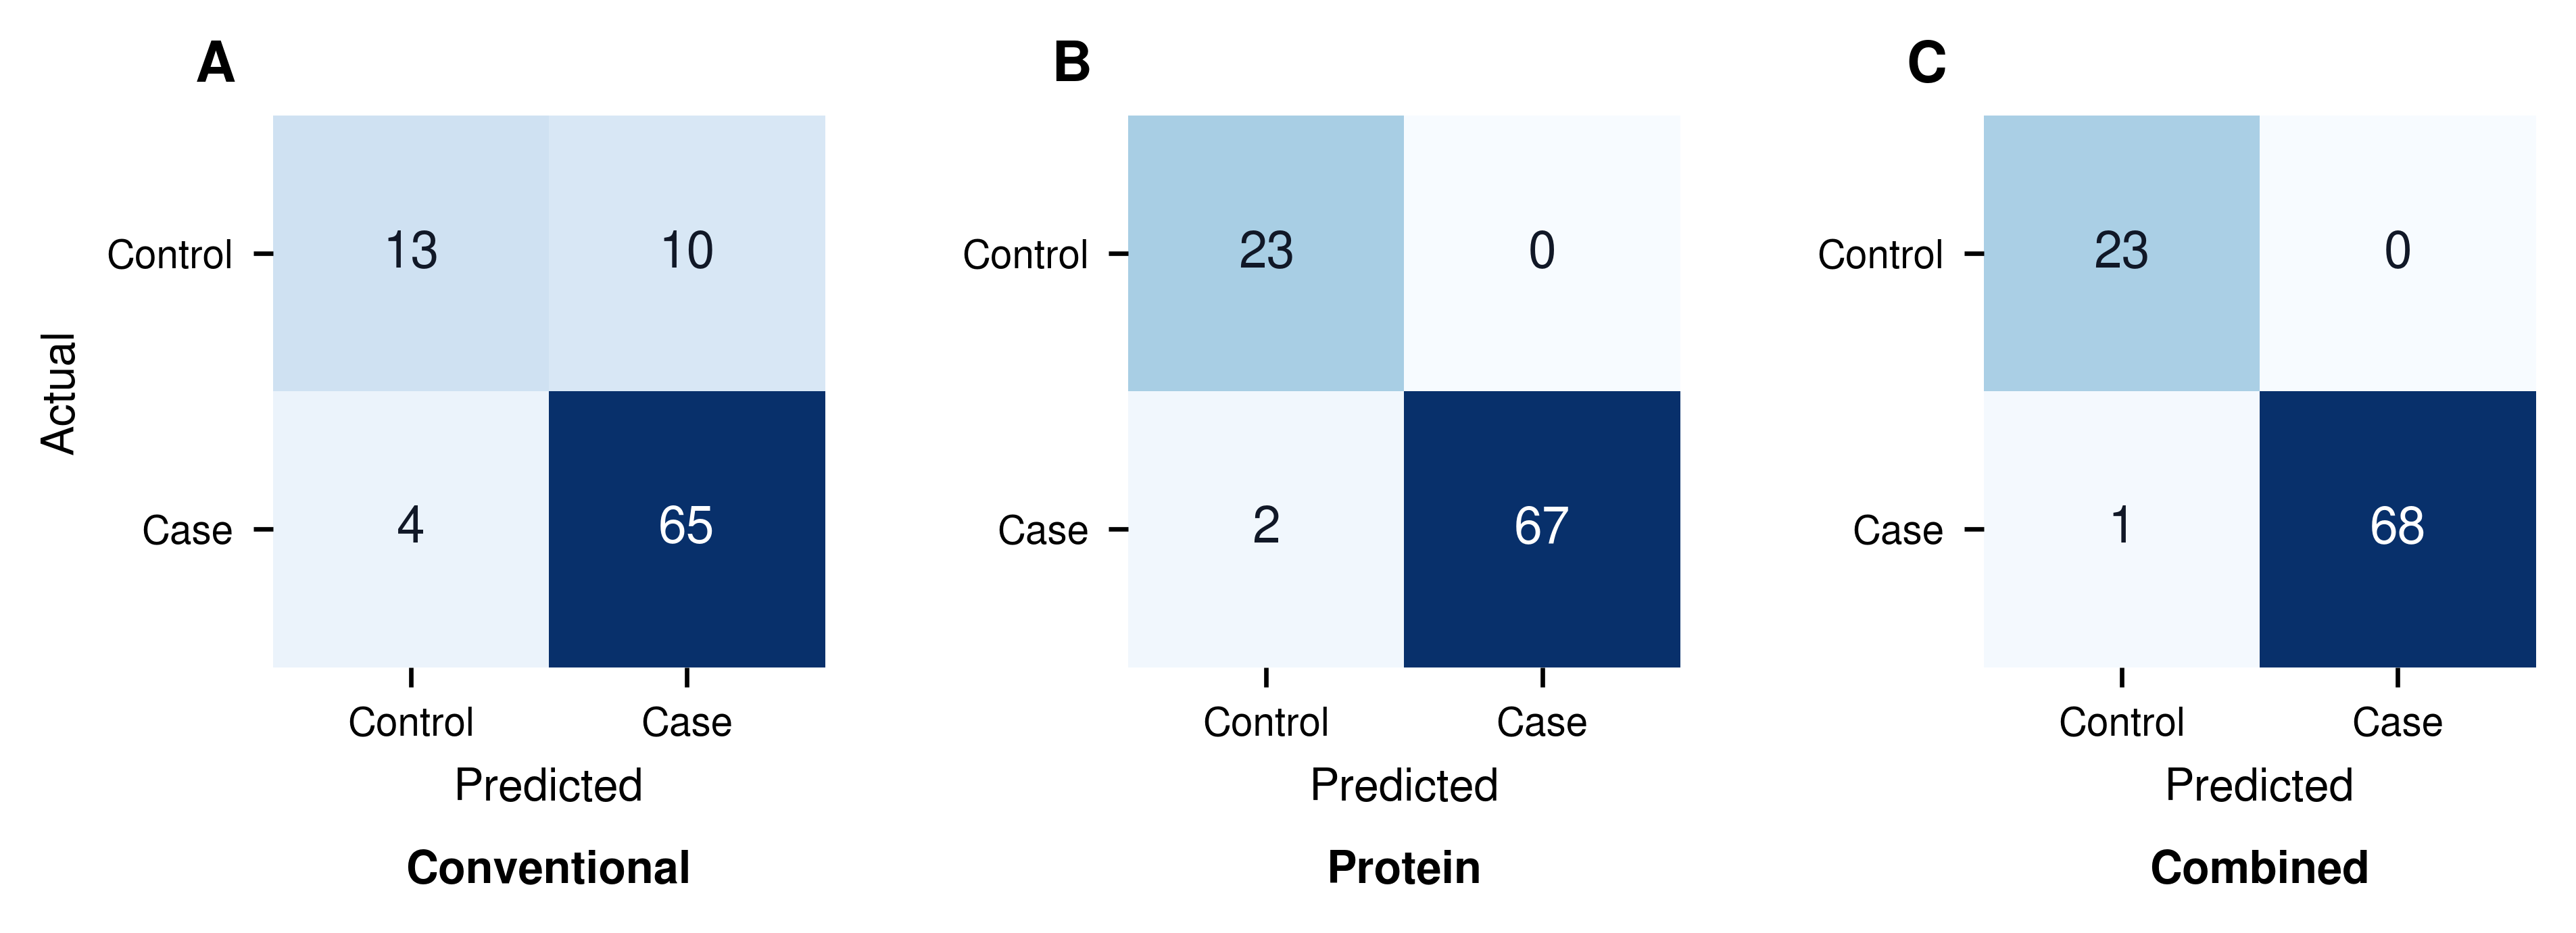
易算生物体液蛋白组诊断生物标志物分析示例。
真实类别与预测类别交叉列出人数,假阳性和假阴性可直接按模型比较。矩阵呈现的是固定阈值下的分类结果,同一模型阈值变化时这些人数也会改变;受试者资料另用于描述误判患者的临床构成。
图12 嵌套交叉验证中的模型评分差异
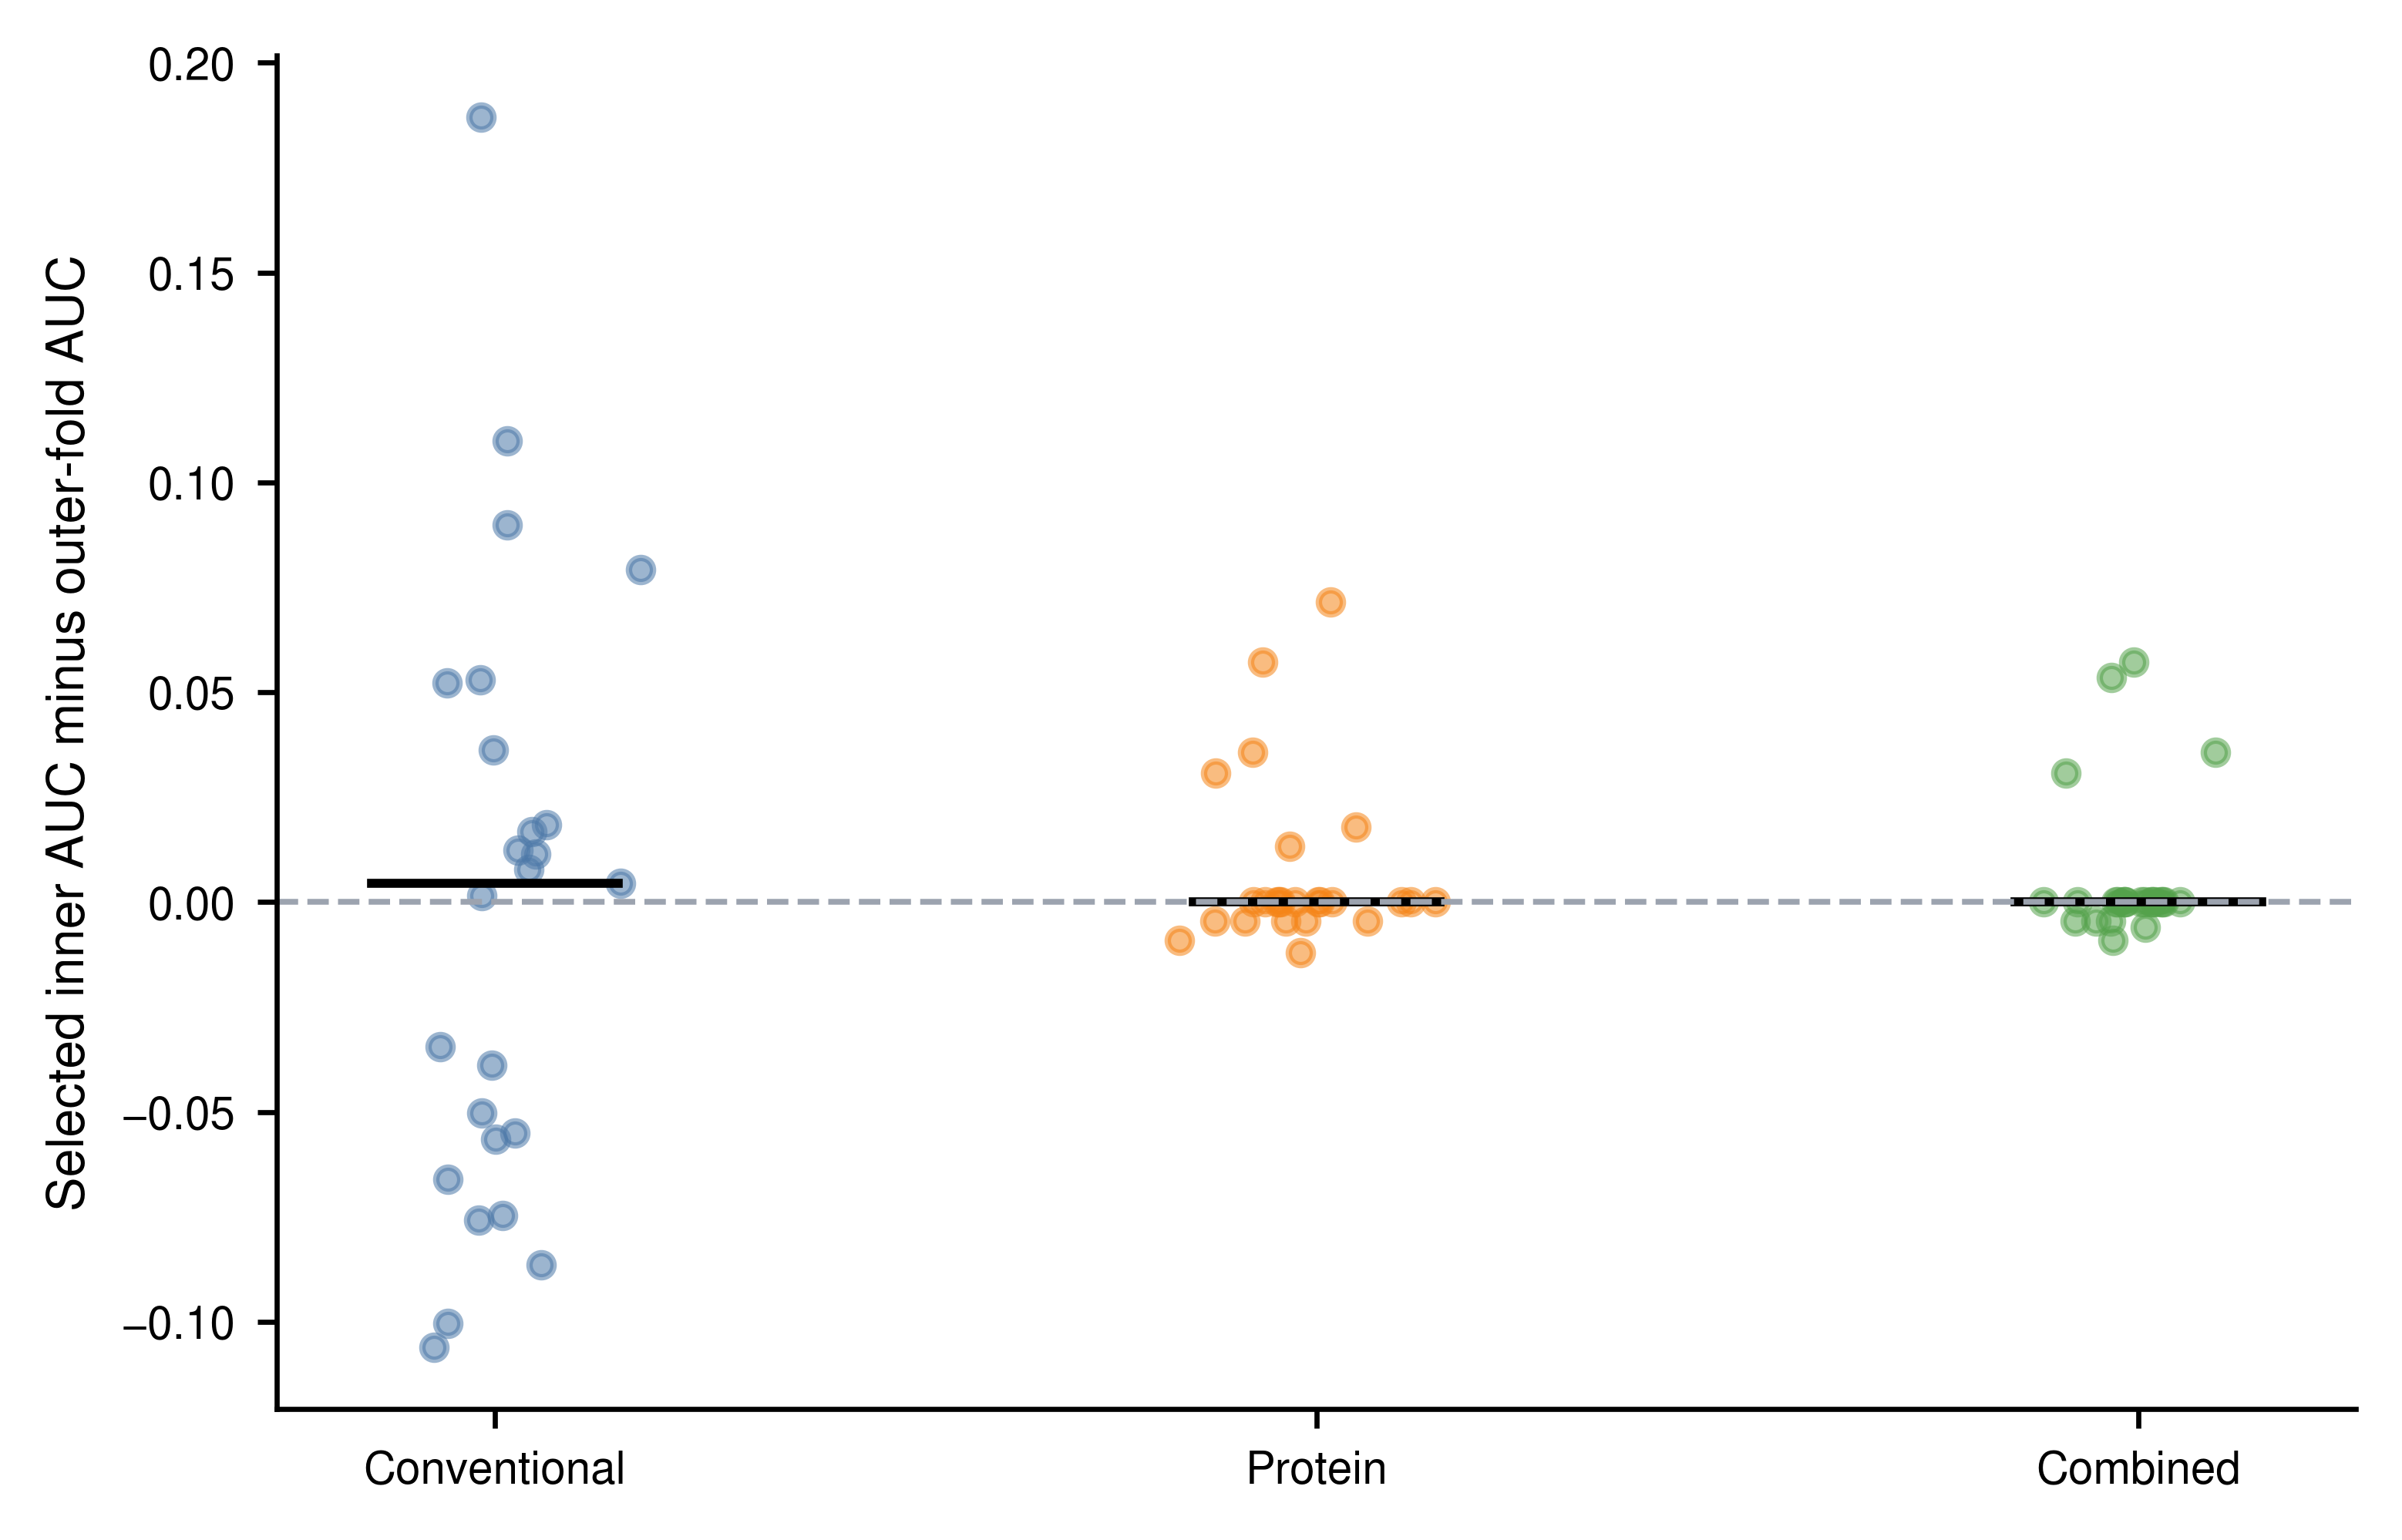
易算生物体液蛋白组诊断生物标志物分析示例。
内层评分用于模型选择,外层保留样本评分评价所选模型,每个点表示两者在一次训练中的差值。差值分布显示选择阶段与评价阶段的表现距离,以及这种距离随患者划分的波动;不同模型在相同重复设计下比较。
图13 联合模型中候选蛋白的入选频率
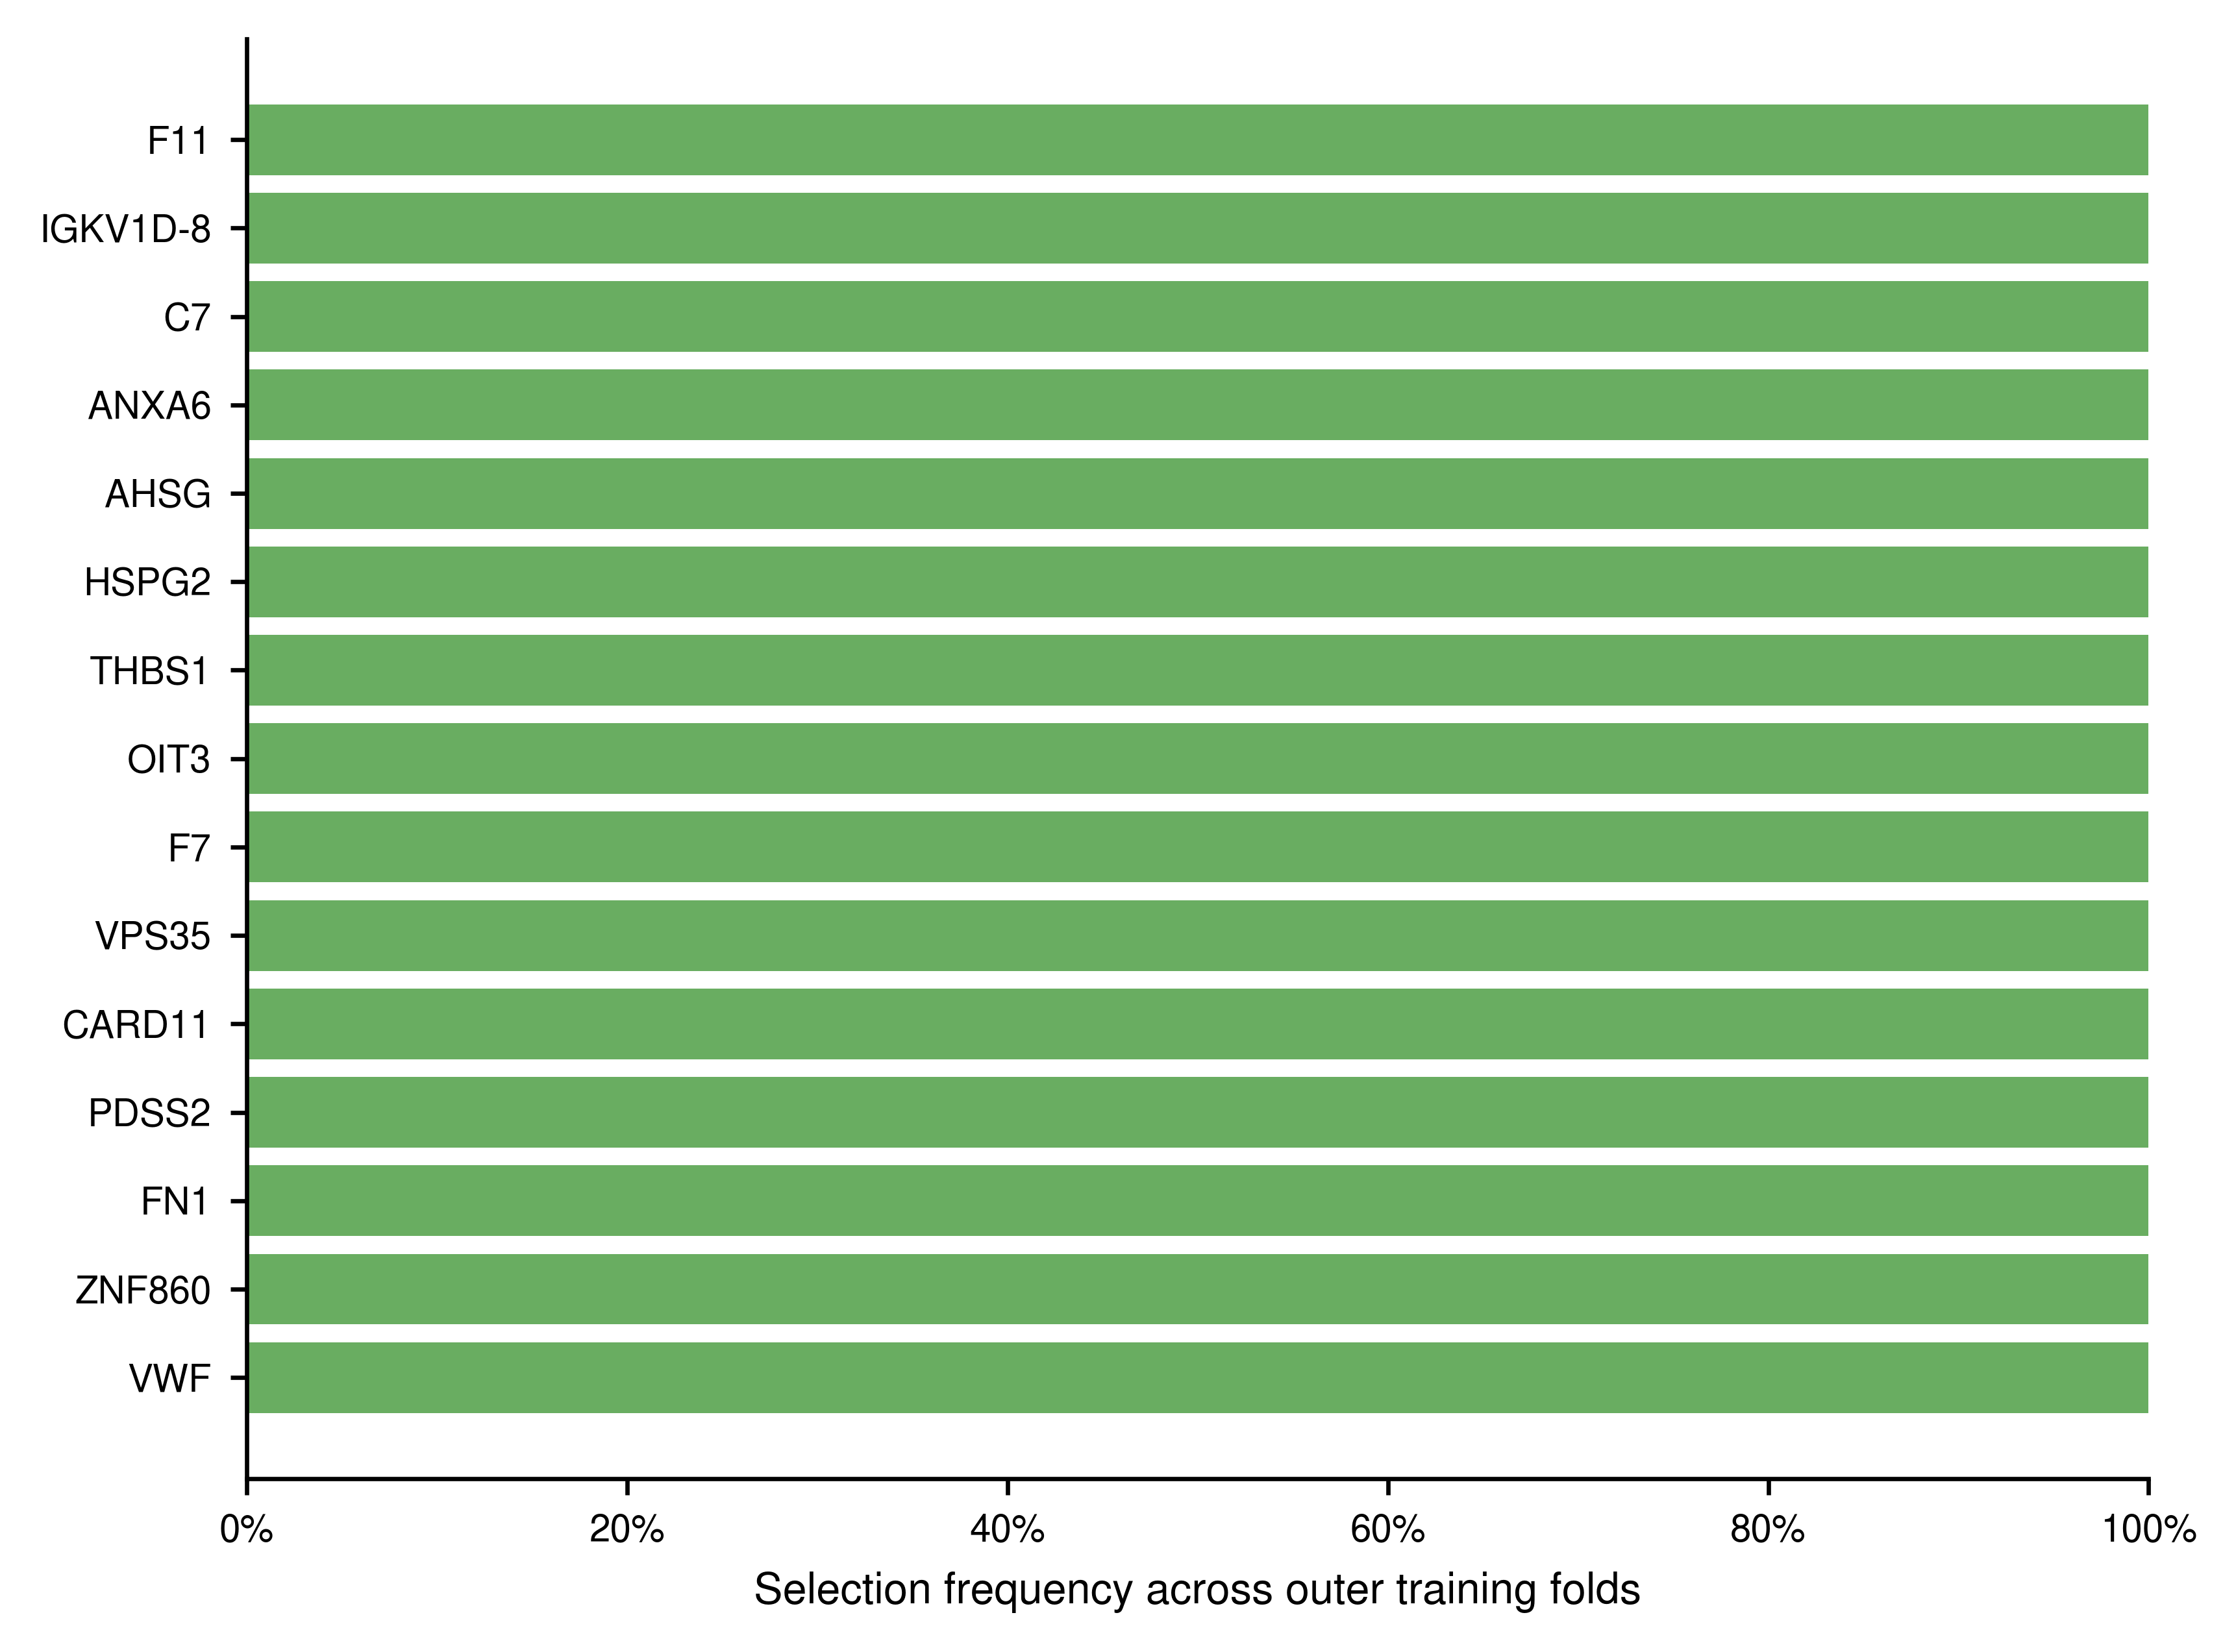
易算生物体液蛋白组诊断生物标志物分析示例。
入选频率表示训练样本重新划分后候选再次进入模型的程度。图示候选均反复入选,其系数方向、丰度相关性和功能仍需分别比较;精简组合时,还要评价移除某个蛋白后预测表现的变化,以辨认重复信息。
图14 不同病理分期的联合模型评分
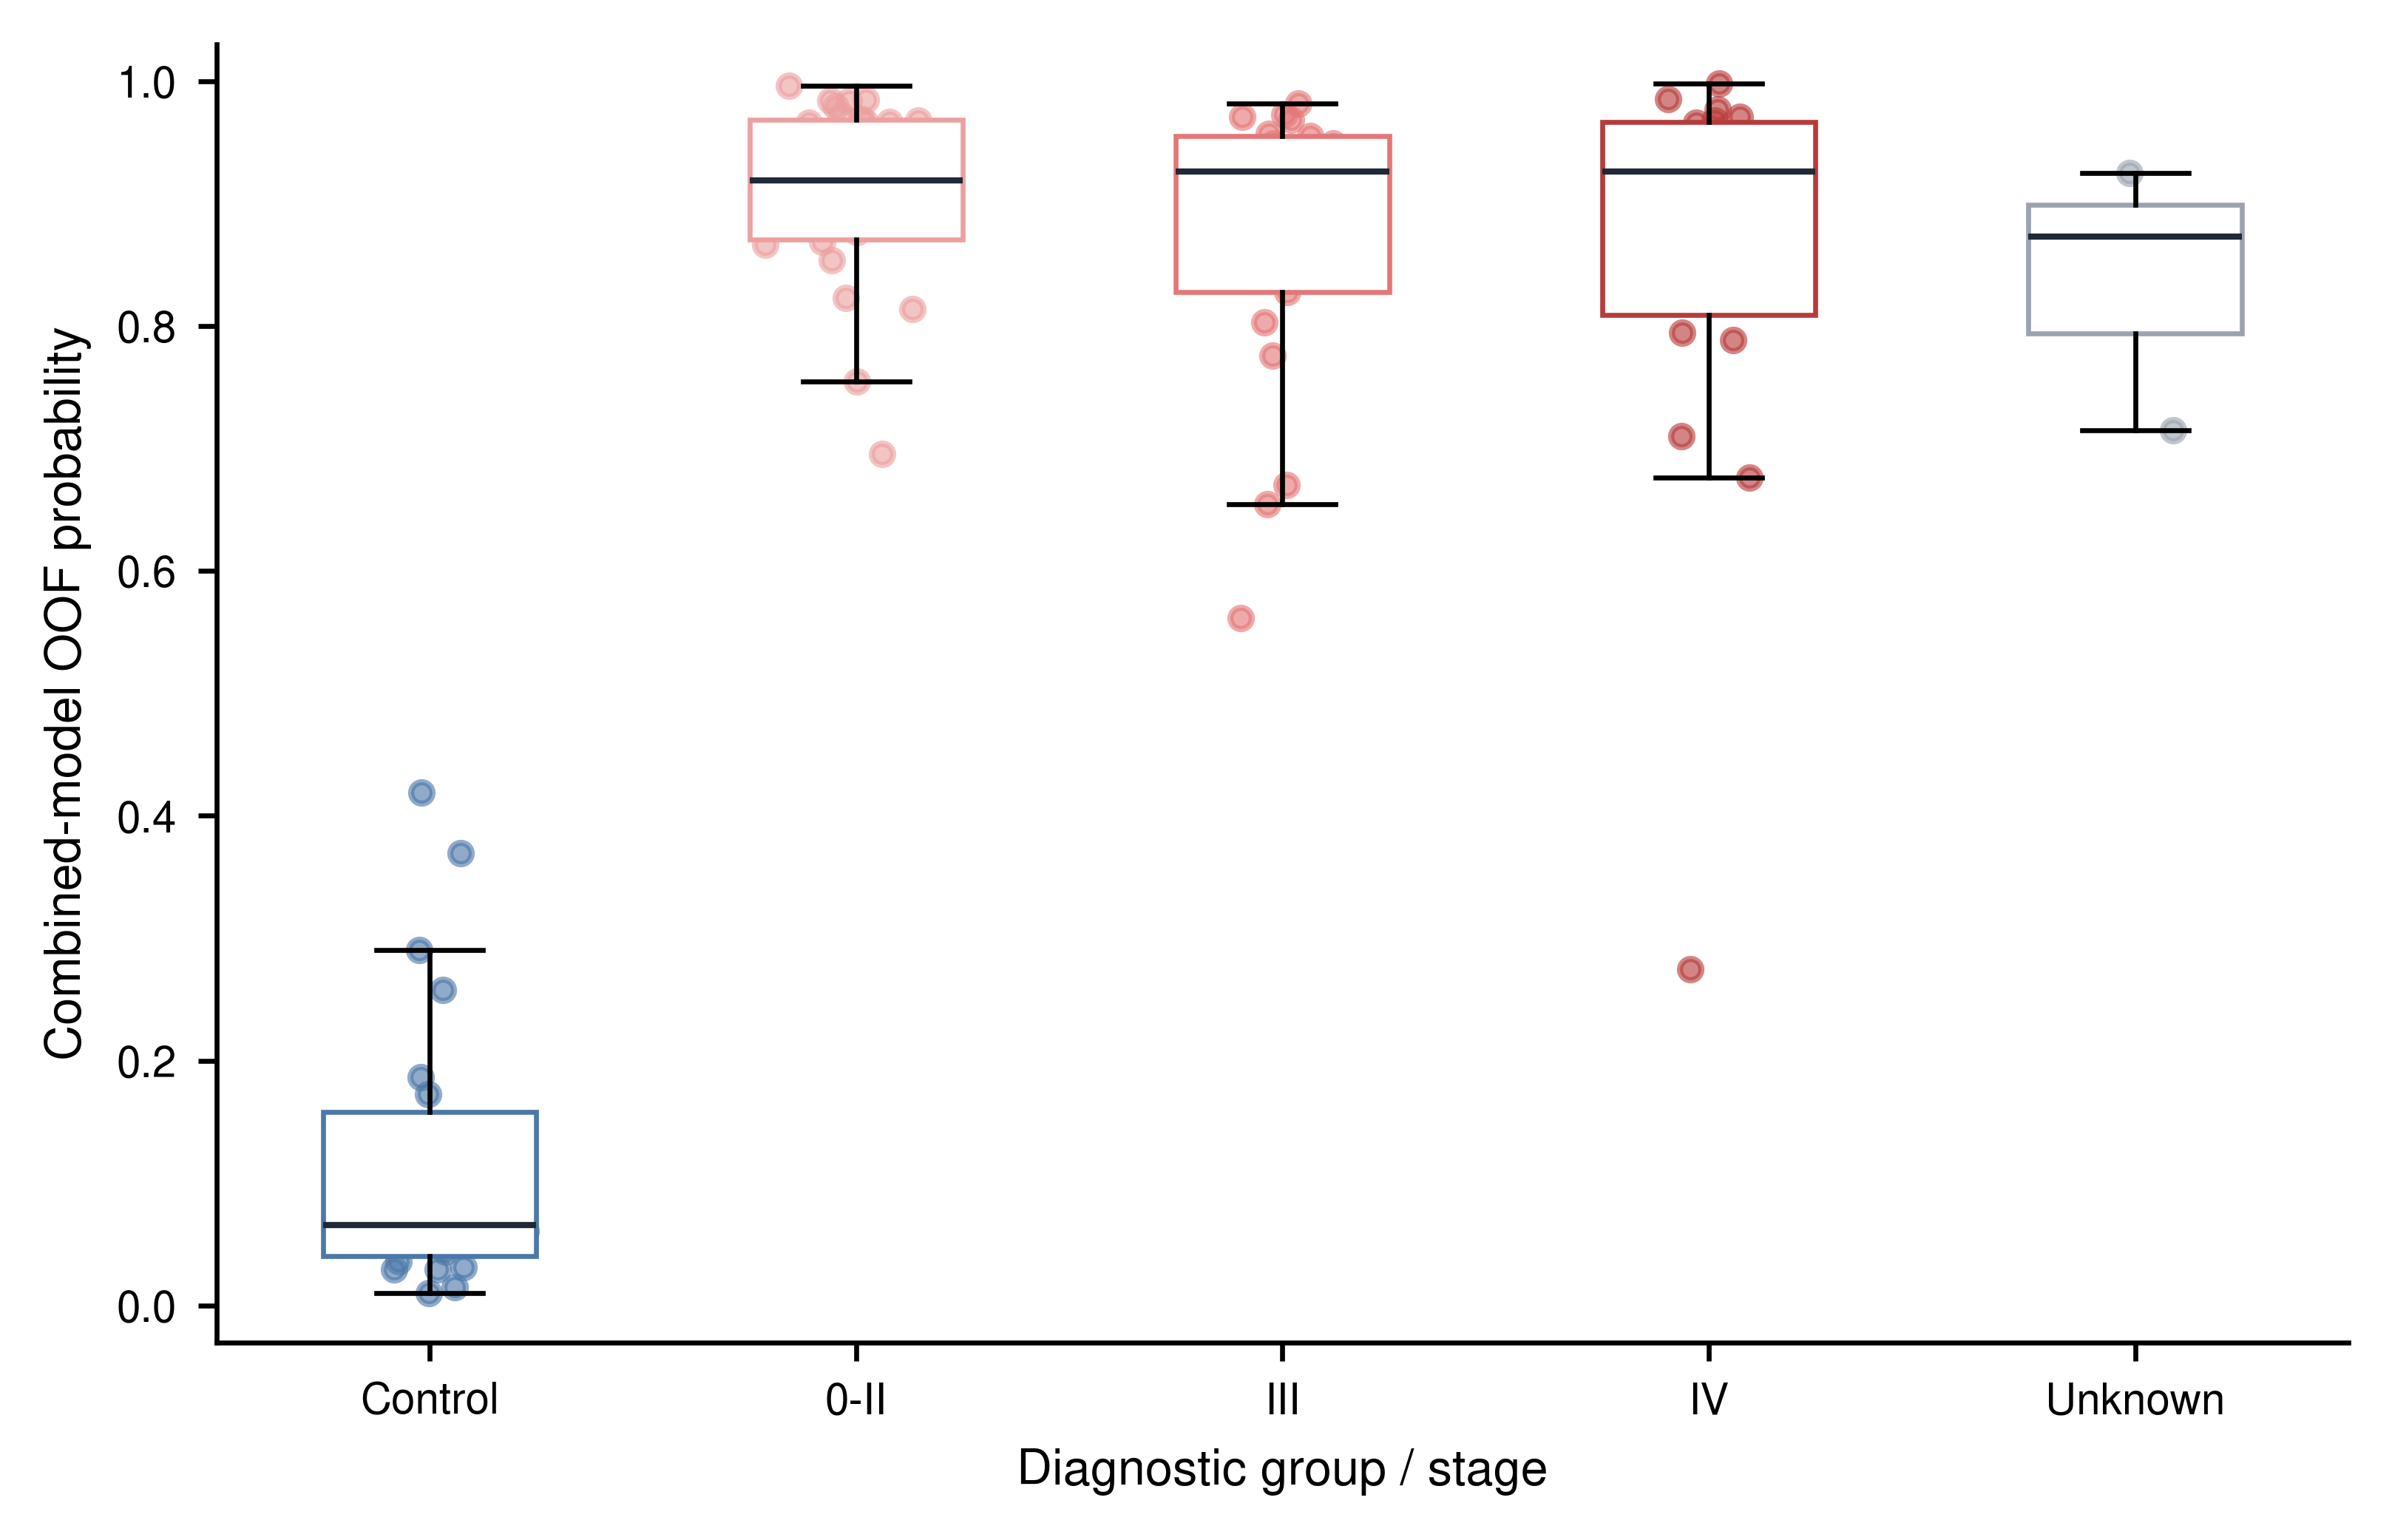
易算生物体液蛋白组诊断生物标志物分析示例。
各病理分期沿用同一联合模型的折外评分,箱线图与个体点显示亚组内差异及组间重叠。总体区分度汇总全部病例,而此图保留各阶段的评分分布;早期病例ROC进一步给出相应子集与对照之间的排序表现。
项目咨询
请提供研究问题、样本类型与数量、分组方式,以及已有的病理、临床、随访或配套组学资料。已有检测结果可附报告目录或数据字段说明。
邮件咨询 · multiomics@omicsolution.com