宏蛋白质组检测混合微生物群落中表达的蛋白,比较疾病、饮食、药物或环境条件下的功能变化。配套宏基因组提供微生物组成与功能基因信息,粪便和血浆代谢组分别测量相应基质中的小分子。将这些数据与临床资料按受试者对应,可分析微生物功能蛋白、代谢物及宿主表型之间的关联。
易算生物根据样本基质、群落复杂度和主要比较设计宏蛋白质组检测与分析。通过适配的序列数据库完成肽段和蛋白鉴定,匹配微生物来源与功能注释,再比较疾病分组、干预阶段或表型相关的丰度变化。研究既可聚焦指定微生物的功能蛋白,也可汇总不同微生物中参与同一代谢过程的蛋白。
适用研究场景
肠道微生态研究可围绕营养方式、炎症状态、感染相关表型和治疗反应设置分组,比较微生物功能蛋白及其与宿主代谢的关系。微生态干预项目可以设置干预前后配对或连续随访,评价功能变化的方向、出现阶段和个体间一致性。菌群培养、发酵与其他复杂微生物样本,则可以围绕培养条件、产物形成和群落稳定性设计实验,按实际基质确定蛋白提取与数据库范围。
已有宏基因组的项目可增加蛋白检测,比较功能基因与实际蛋白表达的对应;已有宏蛋白及代谢数据时,可分析功能酶与代谢物的样本间关联。检测组合根据主要研究问题、样本对应关系及现有数据覆盖确定。
服务特色
蛋白鉴定结果同时提供微生物来源注释。可唯一归属的肽段和蛋白按其分类单元报告;同源序列共享的肽段按蛋白组或较高分类层级汇总,分类分辨率由实际质谱证据确定。
菌群组成与功能变化分别评价。群落中某个分类单元的蛋白信号增加,可能同时包含该类微生物数量变化与蛋白表达变化;项目结合宏基因组或同分类单元的蛋白背景,分析功能变化所处的层级。多组学联合先统一样本对应关系并分别预处理各数据层,再分析蛋白、功能集合和代谢信号之间的关联。
易算生物分析示例
分析项目
样本对应 搜库与鉴定定量
- 样本与组学对应:按受试者或实验单位连接宏蛋白、宏基因组、体液及粪便代谢,整理分组、时间点和批次,形成各项分析使用的样本集合。
- 搜库资源与蛋白映射:结合匹配宏基因组翻译序列或参考蛋白库组织搜索结果,输出肽段、蛋白组、宿主及微生物来源的对应关系。
- 鉴定数量与定量覆盖:分别统计样本及分组的肽段、蛋白组数量、定量比例和共有特有成员,输出数量分布图、集合图及明细表。
- 丰度与缺失分布:展示样本丰度范围、蛋白检出比例和不同数据层的缺失情况,按基质及分组组织分布图与后续可分析矩阵。
数据分布与宏蛋白差异
- 整体降维与样本聚类:利用主成分分析、样本距离和高变蛋白热图展示群落功能表达结构,并以分组、批次和临床信息解释样本分布。
- 蛋白丰度差异:根据独立分组、患者配对或重复随访建立模型,输出蛋白变化幅度、置信区间、多重比较结果及火山图和表达热图。
- 蛋白检出状态比较:对稀疏宏蛋白统计各组检出比例及样本分布,将检出状态变化与可定量样本中的丰度变化分别整理。
- 多组差异与候选分布:并列展示不同临床分组或干预比较的共同与特有蛋白,以效应图、集合图及个体分布图呈现候选变化模式。
微生物分类来源与功能组成
- 分类来源组成:按肽段和蛋白映射支持的属、种或较高分类层级汇总微生物蛋白信号,展示各样本及分组的来源组成与分布。
- 分类单元相关变化:比较目标分类单元所对应蛋白的丰度、检出覆盖和组间效应,形成菌群来源与功能蛋白相对应的候选列表。
- 分类与功能交叉展示:将酶、反应和功能类别与微生物来源共同组织,输出分类单元与功能矩阵,展示同一功能由哪些群体的蛋白构成。
功能集合 通路与分子网络
- 功能注释与差异富集:围绕项目可检测、可注释的宏蛋白开展功能集合分析,分别整理全部、上升和下降蛋白涉及的过程及成员。
- 连续统计量的集合分析:按蛋白差异或表型关联统计量开展GSEA或GRSA,输出功能集合得分、方向、校正结果与主要贡献蛋白。
- 功能交集与聚类网络:比较不同组别涉及的功能,利用共同成员关系归纳功能主题,提供共有特有功能表、集合图及功能相似性网络。
- 功能与蛋白对应网络:围绕碳源利用、氨基酸代谢或应激等研究过程,连接功能成员并叠加蛋白效应,输出功能图、分子热图和网络。
共表达模块与代表蛋白
- 宏蛋白共表达模块:在样本量及共同观测覆盖适合时构建WGCNA网络,输出软阈值结果、模块树、模块成员及样本层模块分数。
- 模块稳定性分析:通过分层子抽样比较模块成员重叠及模块分数的一致性,汇总不同样本组合下可重复出现的宏蛋白模块。
- 模块与表型关联:比较各模块在疾病或干预分组中的分布,并估计其与临床连续指标的调整关联,输出效应矩阵及关联图。
- 模块来源与核心蛋白:综合模块内连接、成员相关性、微生物来源和功能富集,整理代表蛋白与模块网络,并展示候选的个体丰度。
宏基因组与宏蛋白组对应
- 分类与功能覆盖对应:在同一样本中统一宏基因组和宏蛋白组的分类单元及功能标识,汇总两层共同覆盖和各自覆盖的成员。
- 基因与蛋白变化比较:分别计算基因层与蛋白层的组间效应,按共同分类或功能单元展示同向、反向及单层变化,形成跨层效应矩阵。
- 组成背景与功能表达关联:结合宏基因组分类丰度及同分类单元蛋白背景,分析目标功能蛋白的样本层关联及其在分组调整后的表现。
多组学因子与共同变化
- MOFA多层联合建模:整合宏蛋白、宏基因组、血浆和粪便代谢矩阵,按实际数据层建立因子模型,输出样本得分、特征权重和因子结果。
- 因子方差解释:分别计算各因子对各数据层变异的解释比例,展示方差解释率矩阵,识别共同变化较集中的数据层及样本层因子。
- 因子与样本表型:展示因子在不同分组中的样本分布,估计组间效应及与临床指标的关联,并通过散点图与效应区间表达结果。
- 高权重特征与因子网络:分别展示各层高权重特征数量、层内占比及权重方向,结合功能注释构建因子相关特征的热图与关联网络。
- 多模型因子一致性:在属、种分辨率、数据层组合及重复拟合之间比较样本得分和特征权重结构,输出因子对应及稳定性结果。
代谢信号与临床表型整合
- 代谢信号整理与组间分析:按血浆、粪便分别保留峰标识、离子模式和候选注释,汇总独立信号的组间效应、覆盖及与因子的关系。
- 宏蛋白模块与代谢关联:在对应样本中计算功能模块与代谢信号的相关或偏相关,结合临床分组组织效应矩阵、散点图和关联网络。
- 组学特征与临床指标关联:分别分析因子、模块和代谢信号与连续指标、事件次数或其他目标表型的关系,输出有效样本数、效应及区间。
- 表型整合模型与结果稳定性:按表型类型构建简化回归模型,结合协变量、Bootstrap及留一分析,展示组学特征的关联和个体影响。
样本 搜库资源与宏蛋白定量概览
整理分组、基质、时间点和批次,结合样本匹配宏基因组翻译序列或适用的参考蛋白序列库准备搜库资源,并加入宿主与常见污染物信息。结果保留肽段、蛋白组和分类注释之间的映射,统计每个样本的鉴定数量、定量覆盖、丰度范围与组间重叠。重复性、缺失分布和批次相关变化共同用于确定后续可比较的数据集合。
菌群来源与功能组成
在肽段和蛋白归属支持的分类层级汇总信号,比较主要微生物类群的蛋白构成、样本间差异及组内分布。酶、代谢反应和功能类别注释用于汇集参与同一过程的蛋白,再按分类来源拆分,分析相同功能由哪些微生物的已测蛋白组成,以及其构成是否随分组改变。
差异蛋白与检出模式
按照独立样本、患者内配对或重复随访结构建立比较模型,输出变化幅度、效应区间和多重检验结果。稳定定量蛋白侧重丰度差异,稀疏特征可补充检出比例比较,并结合样本覆盖解释结果。对重点候选提供个体分布、分类来源和功能注释,进一步区分广泛的群落构成变化与集中在特定功能过程的变化。
功能集合 共表达模块与核心蛋白
围绕碳源利用、氨基酸代谢、应激反应或项目关注的其他过程开展功能集合分析;背景集合根据本项目可检测与可注释的蛋白确定。样本量和覆盖适合时,依据跨样本共同变化构建蛋白模块,通过重采样评价成员与模块分数的稳定性。模块再与分组、临床指标或实验条件关联,并结合微生物来源识别具有代表性的功能蛋白。
宏基因组与宏蛋白组对应分析
同一样本具有宏基因组时,按分类单元和功能标识匹配两组学,比较功能覆盖、组间效应和样本间相关性。宏基因组描述功能基因及群落组成,宏蛋白描述检测到的蛋白表达;纳入分类单元丰度后,可分析相关功能蛋白是否仍存在组间差异或表型关联。方向一致与不一致的功能分别列出,并保留基因、蛋白及来源注释。
代谢 临床表型与多组学因子
同一受试者的宏蛋白、宏基因组和代谢数据可开展分层关联或 MOFA 多组学因子分析。因子模型以样本得分概括共享或数据层特有的变化,分别报告各因子对各层的方差解释率。高权重特征的功能、分类来源和代谢物注释用于解释因子,临床分组、药物及营养等变量用于分析样本得分的关联;血浆和粪便代谢始终按各自基质处理。
需要提供的样本与资料
样本资料包括基质、采集与保存方式、分组、独立受试者或实验单位、用药或干预信息及批次;纵向项目另需采样日期和事件时间。宏基因组联合项目提供原始或已处理序列资源、分类与功能结果及对应样本表,代谢联合项目提供样本基质、定量矩阵、峰或信号标识、候选注释和注释等级。
样本数量、蛋白起始量和检测配置结合微生物复杂度、主要比较、预实验变异及配对完整度确定。对同一受试者多个时间点、同一培养体系多个取样点分别保留关系,统计分析以预先定义的独立实验单位展开。
因子示例分别列出各数据层的方差解释率、高权重特征数量及层内占比:解释率概括捕获的数据变化,数量和占比描述重要特征的分布。再按特征的微生物来源及功能注释,可确定因子涉及的蛋白、代谢物和相关过程。
服务流程
研究设计确定样本基质、分组与联合数据,检测方案据此选择前处理、质谱采集及序列数据库。鉴定定量后完成样本质控、分类与功能注释,并按独立分组、配对或随访设计估计差异。约定的模块及多组学分析进一步筛选相关功能和分子组合,报告列出对应的靶向复测或培养干预对象。
交付内容
提供宏蛋白定量矩阵、肽段与蛋白组映射、分类和功能注释、质量评估、差异结果及约定的模块或联合分析结果。图表配套作图数据,统计结果保留有效样本数、效应量与显著性指标;分析说明记录数据库、软件版本、过滤、归一化和模型设置。重点候选清单同时列出微生物来源、功能依据、跨组学表现和可进一步研究的问题。
项目咨询:请提供研究问题、样本类型与数量、分组设计及相关病理、临床或配套组学资料。多组学与生信定制咨询:multiomics@omicsolution.com。
图文示例
图文为分析方法、公开数据再分析或研究示例。示例中的样本数量、效应和模型性能对应各自数据与分析条件,不代表其他项目的结果保证。服务用于科研;候选关系与预测结果不能替代机制验证、独立队列验证或临床诊断。
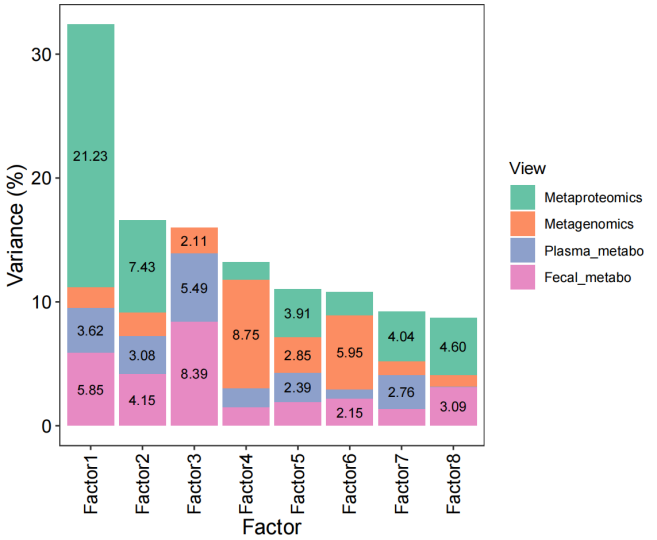
图2 分析展示 共同因子对各组学层的方差解释
易算生物分析示例
因子间的解释率分布显示各组学变化由哪些因子概括,单个因子在不同数据层的解释率则显示其影响范围。宏蛋白层解释率较高时,可展开相应蛋白权重及功能注释,确定该因子主要涉及哪些已测微生物功能。
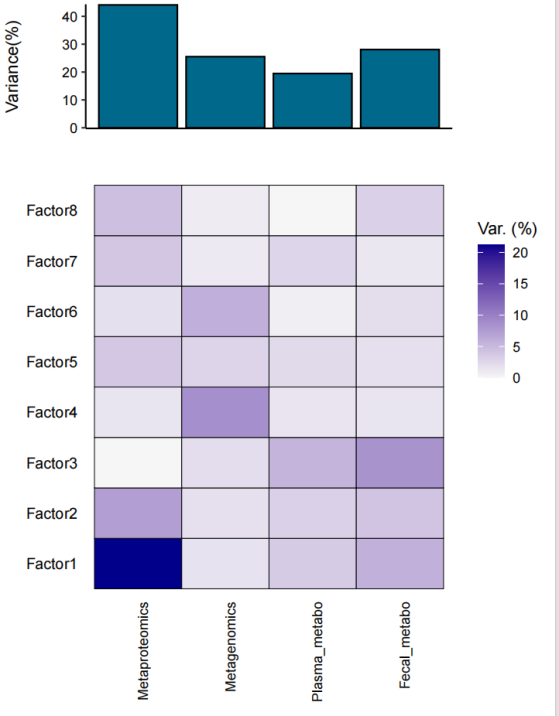
图3 分析展示 因子与数据层的解释矩阵
易算生物分析示例
沿行读取可比较同一因子在四层中的解释率,沿列读取可判断某个数据层的变异由哪些因子概括。矩阵同时呈现跨层共享和单层占主导的模式,上方汇总柱便于比较各层被模型解释的总体情况。
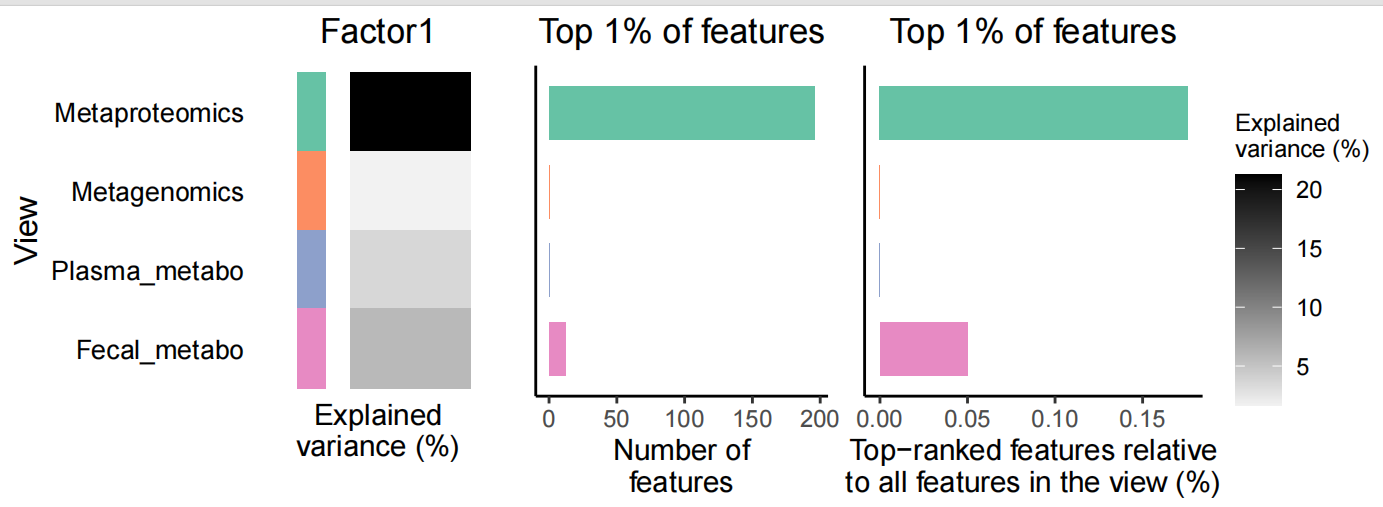
图4 分析展示 单个因子的解释率与高权重特征
易算生物分析示例
因子 1 的方差解释率描述其概括各层变异的程度,前 1% 特征数量及层内比例显示高权重成员分布。将解释率、入选数量和层内比例并列,可区分方差解释较多的数据层与高权重特征较集中的数据层。
图5 分析展示 样本在共同因子上的连续分布
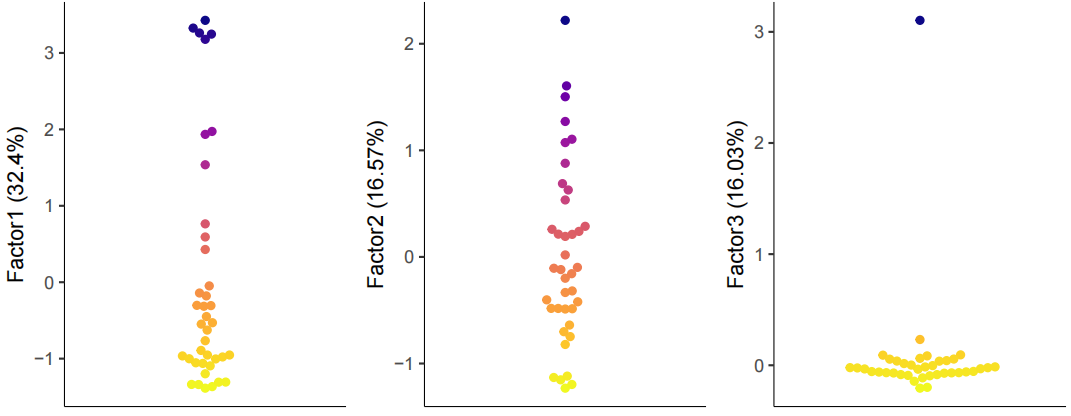
易算生物分析示例
前三个因子的散点分别显示样本得分的范围、密集区间和极端观测。连续分布能够保留分组标签以外的患者差异,适合与采样阶段或连续临床指标比较;极端得分对应的样本可进一步查看其高权重蛋白及代谢物分布。
图6 分析展示 共同因子与样本分组的对应
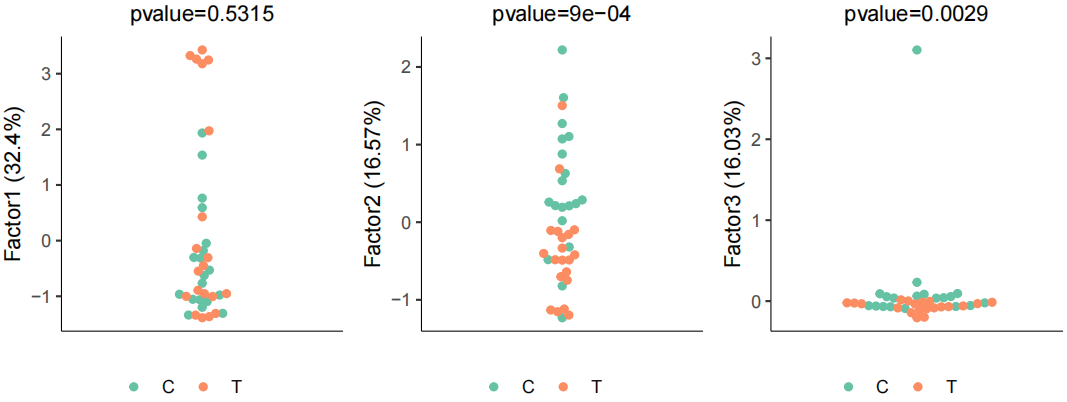
易算生物分析示例
C/T 着色显示各因子的组间差别、组内离散及重叠,图中 P 值对应组间检验。进一步评价分组关联时,可在模型中纳入年龄、用药及营养状态,并结合相应分子特征解释结果。
图7 分析展示 按因子得分排列的高权重特征
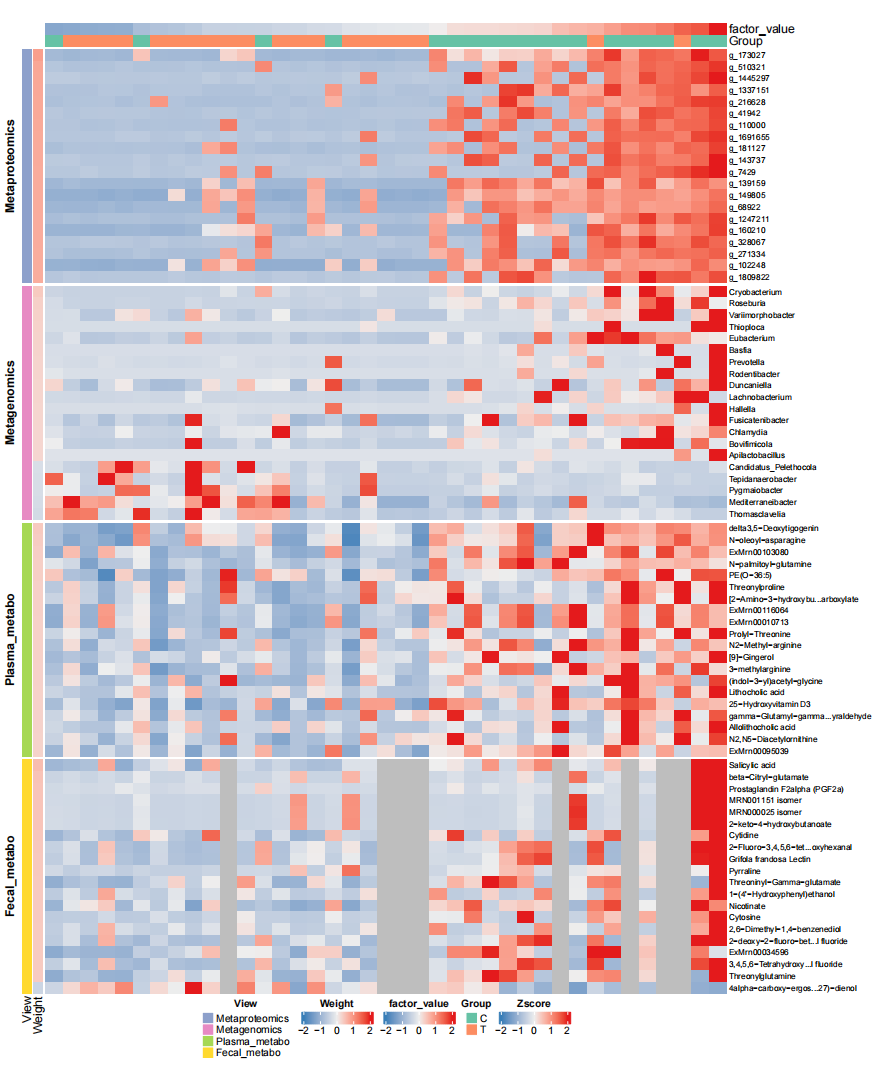
易算生物分析示例
样本按因子得分排列后,各层高权重特征的丰度梯度可以逐行比较。正负权重区分相反方向的模式,侧边注释保留特征来源;由此可定位沿同一梯度变化的宏蛋白、微生物特征及代谢物。
图8 分析展示 按研究分组展示共同因子特征
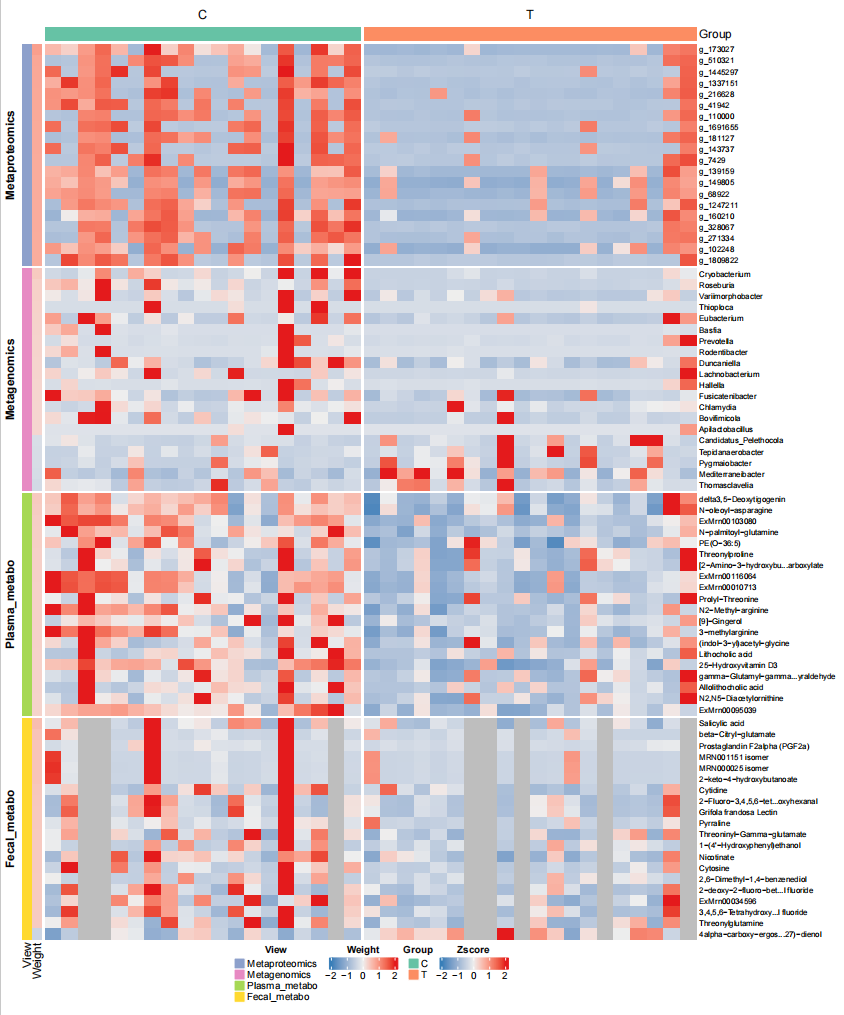
易算生物分析示例
同一组高权重特征改按 C/T 分组排列,显示两组内部的样本差异及组间丰度分布。与按因子得分排序的版本对照,可判断连续梯度是否与研究分组对应,以及哪些特征主要表现为组内差异。
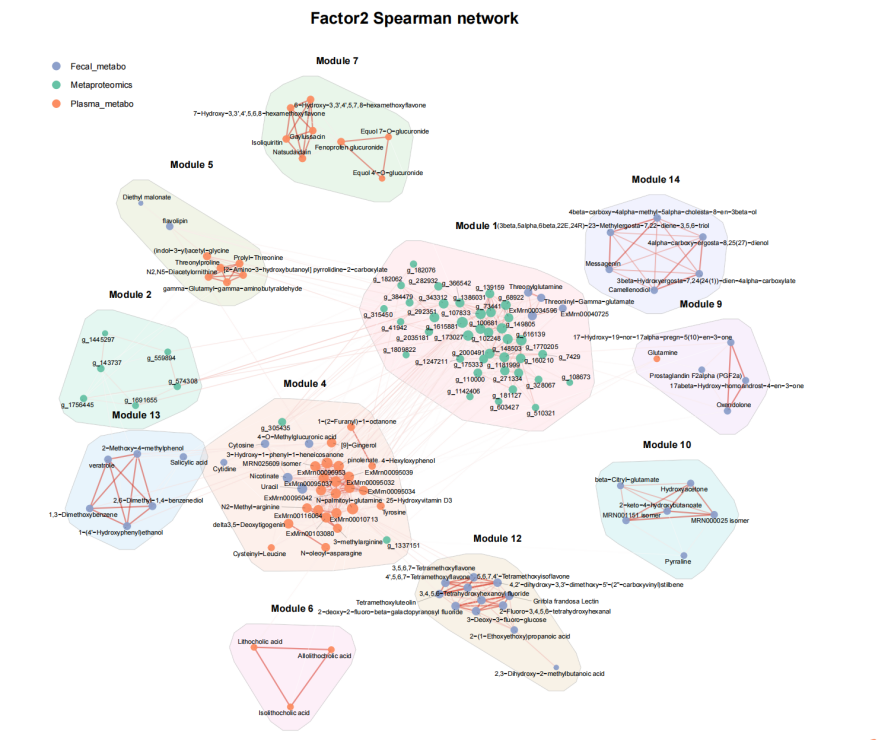
图9 分析展示 因子相关特征的跨层关联模块
易算生物分析示例
Spearman 网络连接因子 2 相关特征,社区聚合联系密集的宏蛋白与代谢物。节点颜色标明数据层,连接度显示与其他成员的关联数量,成员注释用于识别模块涉及的微生物功能及代谢过程。
项目咨询
请提供研究问题、样本类型与数量、分组方式,以及已有的病理、临床、随访或配套组学资料。已有检测结果可附报告目录或数据字段说明。
邮件咨询 · multiomics@omicsolution.com