基线蛋白丰度与后续生存、疾病进展或复发的关系,通过预后关联和风险预测分别研究。本服务使用体液或组织蛋白组及随访资料,估计单蛋白效应、描述患者亚群,并比较临床、蛋白与联合模型的风险排序和概率预测。结果附候选分子、患者预测值及模型参数,具备独立队列时评价新患者中的表现。
适用研究场景
治疗前体液队列适合研究基线蛋白状态与后续总生存或进展的关系;手术组织及同期血浆可以用于分析复发风险,已有长期随访的病理队列可用于寻找与结局相关的分子过程。项目围绕明确的预测起点安排取样,结合主要事件、治疗背景和可获得临床资料确定分析范围。
多个治疗组的队列可分别估计组内预后关联,并通过交互项比较关联在治疗组间的差异;独立队列则用于评价既定候选和风险模型。一年生存等固定时间目标采用相应的结局分类分析,其候选组成和预测表现与保留随访时长的生存模型并列比较。
服务特色 分别评价预后关联与预测表现
单蛋白结果报告丰度与事件发生速率的关联,多变量模型评价组合对新样本的风险排序及概率预测,不同队列的比较则显示人群变化后的表现。各项分析使用一致的预测起点,候选效应、重复入选频率及模型性能分别列出,使单蛋白证据与组合预测的贡献各有对应结果。
训练与评价按独立患者划分,蛋白覆盖过滤、缺失处理、标准化、特征选择及参数调整均在相应训练数据中完成,然后为未参与训练的患者生成预测。重复交叉验证记录每次性能、入选蛋白及系数,显示患者划分后模型表现和候选组成的波动,并比较组合规模与检测复杂度。
分析项目
基线队列与生存结局
- 预测起点与结局整理:对应基线采样日、随访起点、事件类型和删失记录,形成患者层时间结局数据。
- 患者与事件分布:按治疗组及预设临床分层统计患者数、事件数和随访情况,展示主要结局的数据构成。
- 基线蛋白覆盖:统计样本定量深度、各蛋白检出率及缺失模式,形成基线蛋白分析矩阵。
- 基线蛋白整体结构:采用PCA及样本聚类描述患者蛋白状态,附加治疗、临床特征和结局注释。
单蛋白与临床预后关联
- 临床变量Cox回归:估计年龄、性别、治疗及其他指定临床变量与事件发生速率的关系,建立临床参照。
- 全蛋白预后筛选:逐蛋白开展Cox回归,报告风险比(HR)、置信区间及多重检验校正结果。
- 协变量调整预后效应:将治疗方案和预设临床变量纳入模型,估计调整后的蛋白风险关联。
- 比例风险假设评估:检查风险关联随时间的变化特征,并在需要时采用时间相关效应或分层模型。
- 已有候选蛋白分析:按研究提出或文献报告的候选清单,汇总蛋白覆盖、丰度分布及预后效应。
- 治疗组分层与交互:在具有相应治疗设计和事件数时,比较候选蛋白的组内关联及蛋白与治疗的交互效应。
患者蛋白状态与结局分层
- 基线蛋白无监督分群:根据基线表达模式形成患者分群,输出分群归属、特征热图和代表蛋白分布。
- 蛋白分群临床构成:比较各群患者的临床特征和结局状态分布,描述蛋白状态对应的患者组成。
- 群体结局比较:结合随访时间展示蛋白分群的Kaplan–Meier曲线和风险关联,形成分群层的预后描述。
风险模型开发
- 临床风险参照:使用基线可获得的临床变量建立生存模型,输出患者风险评分和预定时点的预测结果。
- 蛋白风险模型:在训练样本内进行数据处理、蛋白选择及正则化建模,形成多蛋白风险评分。
- 临床与蛋白联合模型:在相同患者及结局定义下组合临床变量和蛋白,评价两类信息的共同预测表现。
- 特征选择稳定性:统计蛋白在重采样和交叉验证中的入选频率,输出候选排名及系数分布。
- 模型复杂度分布:记录各次训练所保留的蛋白数和参数规模,展示模型组成在样本变化下的一致程度。
- 训练内参数选择:在各外层训练集中通过内层交叉验证选择正则化参数,输出调参结果及对应的模型组成。
时间相关预测性能
- 患者折外风险预测:在各外层训练折内完成预处理和模型拟合,为对应验证折生成风险与生存概率预测。
- 一致性指数:采用C-index衡量模型对患者事件时间排序的区分能力,汇总重复划分结果及区间。
- 时间依赖ROC与AUC:在预设预测时点评价病例事件状态的区分度,考虑随访删失并展示性能随时间的变化。
- 同次划分模型比较:在相同训练验证划分中比较临床、蛋白和联合模型,报告性能差值的分布。
- 时点概率校准:比较预定时间的预测事件概率与随访估计概率,形成各模型的校准曲线。
- 随时间预测误差:计算考虑删失的Brier评分及其时间曲线,评价各模型的概率预测误差。
风险分层与指定时间结局
- 患者风险分布:排列患者的折外风险评分,并对应随访时长与事件状态,展示风险排序和结局的关系。
- 风险组生存曲线:沿用预设或训练内确定的风险分界,绘制各组Kaplan–Meier曲线并列示在险人数。
- 风险分组稳定性:统计患者在重复建模中的风险组归属,描述分层结果随样本划分的变化。
- 指定时点结局建模:围绕一年生存等预定目标,先处理该时点之前的删失记录,再建立或评价相应的结局分类模型。
- 指定时点蛋白稳定性:汇总时间结局模型的入选蛋白及频率,比较其与生存时间模型候选的关系。
- 指定时点分类性能:在结局状态可确定的患者中,汇总折外ROC、AUC、平衡准确率和Brier评分,并比较预设治疗组。
独立队列与结果汇总
- 最终风险公式:提供蛋白变量、临床变量、数据处理参数和风险评分系数,并说明预测起点及对应结局。
- 独立预后队列评价:按相同预测起点、结局和时间窗口应用既定模型,汇总区分度、校准及预测误差。
- 临床亚组性能:在具备相应事件数的治疗组、疾病阶段或风险层中描述模型表现及效应差异。
- 蛋白信息增量比较:综合临床参照和蛋白联合模型的性能,呈现蛋白信息对既有临床预测的补充程度。
分析解读 从单蛋白效应到患者蛋白状态
单蛋白分析使用Cox回归估计风险比,即给定协变量条件下两种蛋白水平对应的事件发生速率之比,并报告置信区间及多重比较校正结果。年龄、性别、治疗与疾病相关临床指标按研究设计进入模型;风险关联随时间变化时,可采用相应的时间相关效应或分层表达。
基线蛋白聚类描述患者的分子异质性,各群分别比较蛋白组成、临床特征和随访结局。候选既可以来自全蛋白筛选,也可以采用既有研究清单。亚群特征与单蛋白效应并列报告,显示结局差异对应哪些共同表达模式,以及代表蛋白的关联在这些患者中的分布。
分析解读 临床 蛋白与联合模型的比较
项目根据拟应用场景可获得的变量建立临床参照、蛋白模型及临床与蛋白联合模型,在相同患者和结局定义下比较结果。高维蛋白信息可采用正则化生存模型,模型复杂度结合事件数、变量相关性和重复建模表现确定。治疗等设计变量按研究需要作为调整项保留。
嵌套交叉验证在内层选择特征和参数,在外层保留患者上生成折外预测;预测该患者的模型仅由相应训练样本拟合。临床、蛋白与联合模型使用相同划分,因此模型间性能差异与不同随机划分带来的波动可以分别比较。
分析解读 风险排序与概率预测
一致性指数C-index评价可比较患者的风险排序与事件时间顺序是否一致,时间依赖AUC评价指定时间窗的区分度。校准比较预测概率与随访估计,Brier评分按删失条件汇总概率误差。排序、特定时间的分类及概率准确性分别由相应指标描述。
风险分层可按照预设或训练内确定的分界组织患者,配合Kaplan–Meier曲线、在险人数及重复分层结果展示结局差异。独立队列评价沿用同一预测起点、变量处理和终点定义,进一步比较不同中心、疾病阶段或治疗背景中的模型表现。
一年生存或其他指定时点分析先依据随访时间确定事件状态,再计算折外分类概率、AUC和预测误差。生存模型保留患者随访时长与删失信息,固定时点分类则使用预定时间窗的结局,两类模型的候选入选频率与组成并列报告。可评价的预测时间点根据实际随访长度、事件比例及样本覆盖确定,结果注明相应时间范围。
公开数据分析实例
以下图件来自Tognetti等公开胰腺癌血清蛋白组数据的重新分析,使用治疗前基线样本和总生存随访,展示蛋白入选稳定性、折外预测区分度和概率校准。示例的简约临床参照包含年龄、性别和治疗组;图中蛋白模型保留治疗组调整,联合模型进一步加入年龄和性别。
示例以重复嵌套交叉验证为每位患者生成折外预测,同时报告蛋白入选频率、时间相关性能及预测误差。不同规模候选组合的表现由这些结果比较;独立人群评价沿用一致的疾病定义和采样起点,检验既定蛋白与风险模型。
样本与项目资料
提供基线样本类型、采样日期、患者编号、治疗方案、主要临床变量及蛋白定量资料。随访表需包含起点、事件日期、末次随访日期和事件类型;组织项目另需病理类别、取材位置及保存方式。主要终点、预计事件数和目标预测窗口共同决定候选规模及模型评价安排。
已有候选时,可提供蛋白清单、检测方法和研究依据;已有外部样本时,需整理疾病定义、样本基质、检测平台及临床变量,确认开发与验证队列之间的对应条件。候选复测可采用靶向质谱或适用的免疫检测,评价临床样本中的可测性和变化方向。
服务流程与交付结果
预测目标、基线取样和随访记录确定建模人群及时间结局,蛋白覆盖与数据分布确定可用特征。单蛋白和临床关联之后建立风险模型,完成交叉验证及时间相关性能评价。拟复测候选列明入选稳定性和检测条件,独立验证安排注明可用队列与主要终点。
交付包含患者与事件概况、蛋白定量矩阵、预后关联表、候选入选及系数结果、患者折外预测、模型性能和校准结果,以及风险分层图、专题报告和方法说明。需要独立队列应用的项目同时提供模型变量、处理参数、风险公式及对应时间窗口。
项目咨询:请提供研究问题、样本类型与数量、分组设计及相关病理、临床或配套组学资料。多组学与生信定制咨询:multiomics@omicsolution.com。
图文示例
图文为分析方法、公开数据再分析或研究示例。示例中的样本数量、效应和模型性能对应各自数据与分析条件,不代表其他项目的结果保证。服务用于科研;候选关系与预测结果不能替代机制验证、独立队列验证或临床诊断。
图1 预后研究的基线队列与蛋白覆盖
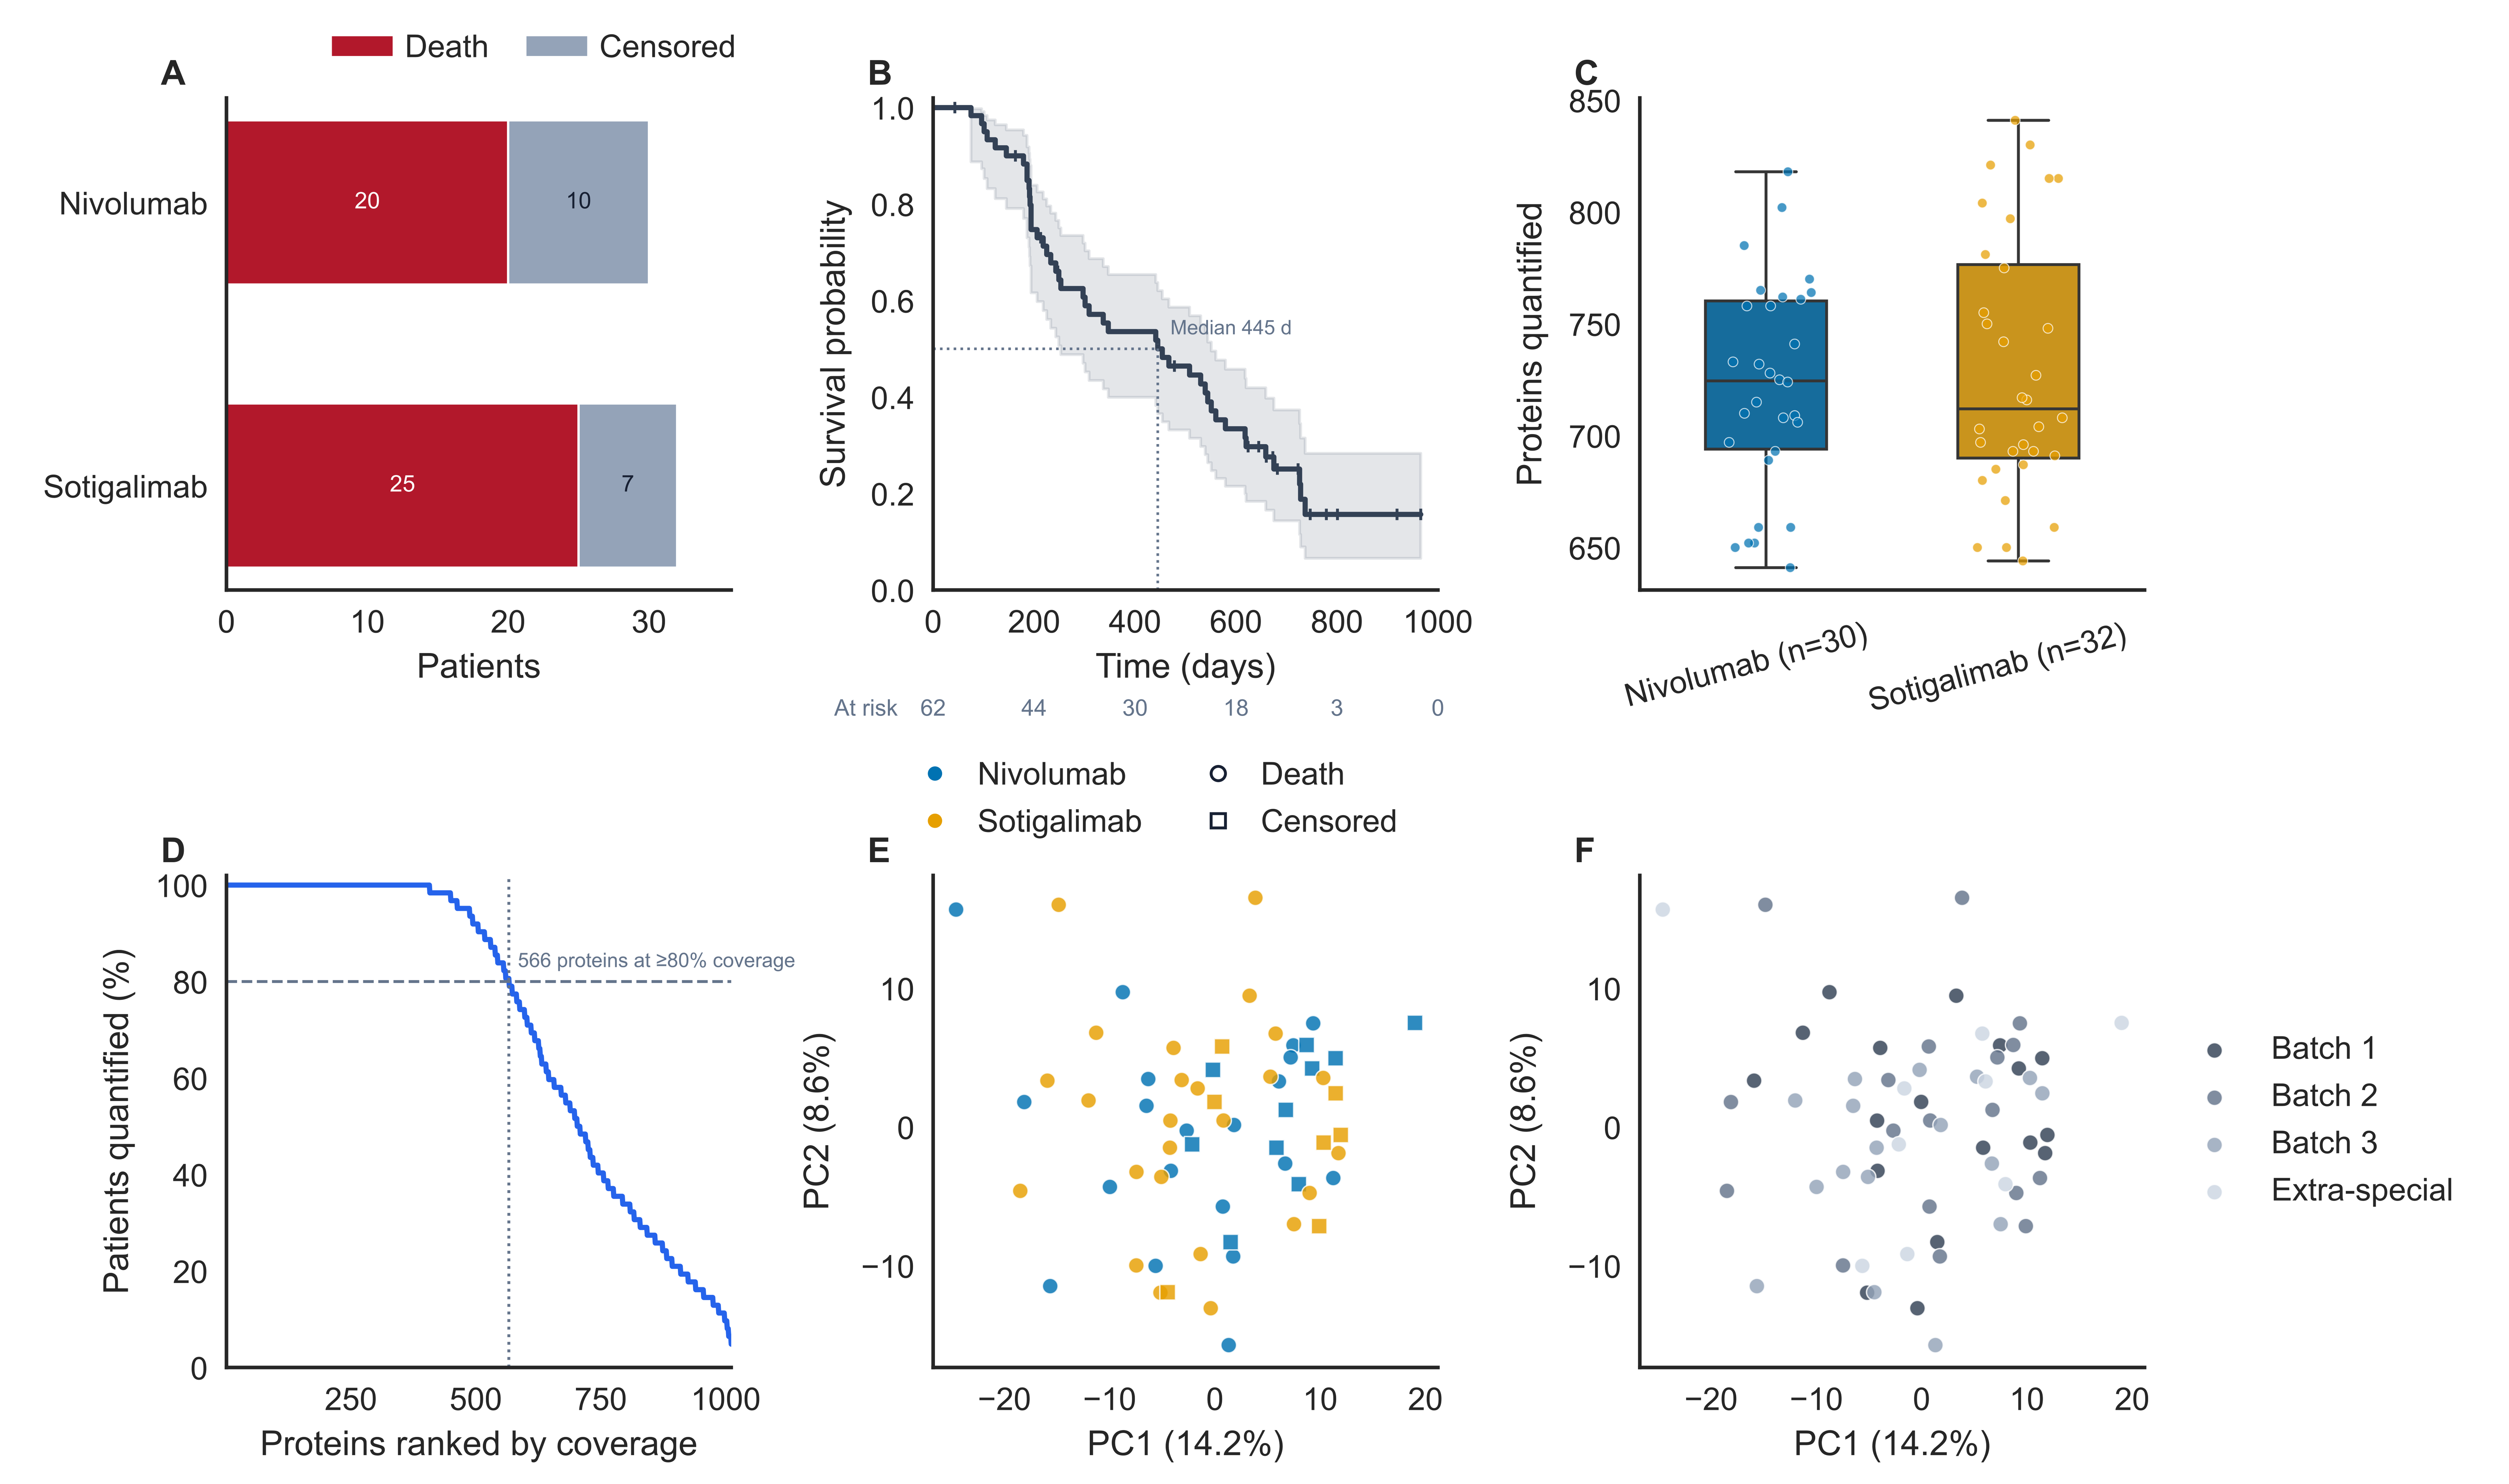
患者构成与事件记录给出生存分析的随访基础,蛋白定量深度与覆盖显示候选筛选的范围。主成分图分别以治疗和批次标注同一批基线样本,呈现整体蛋白差异所伴随的分组信息;这些变量按研究设计进入临床调整和患者分层分析。
图2 基线蛋白亚群及其生存特征
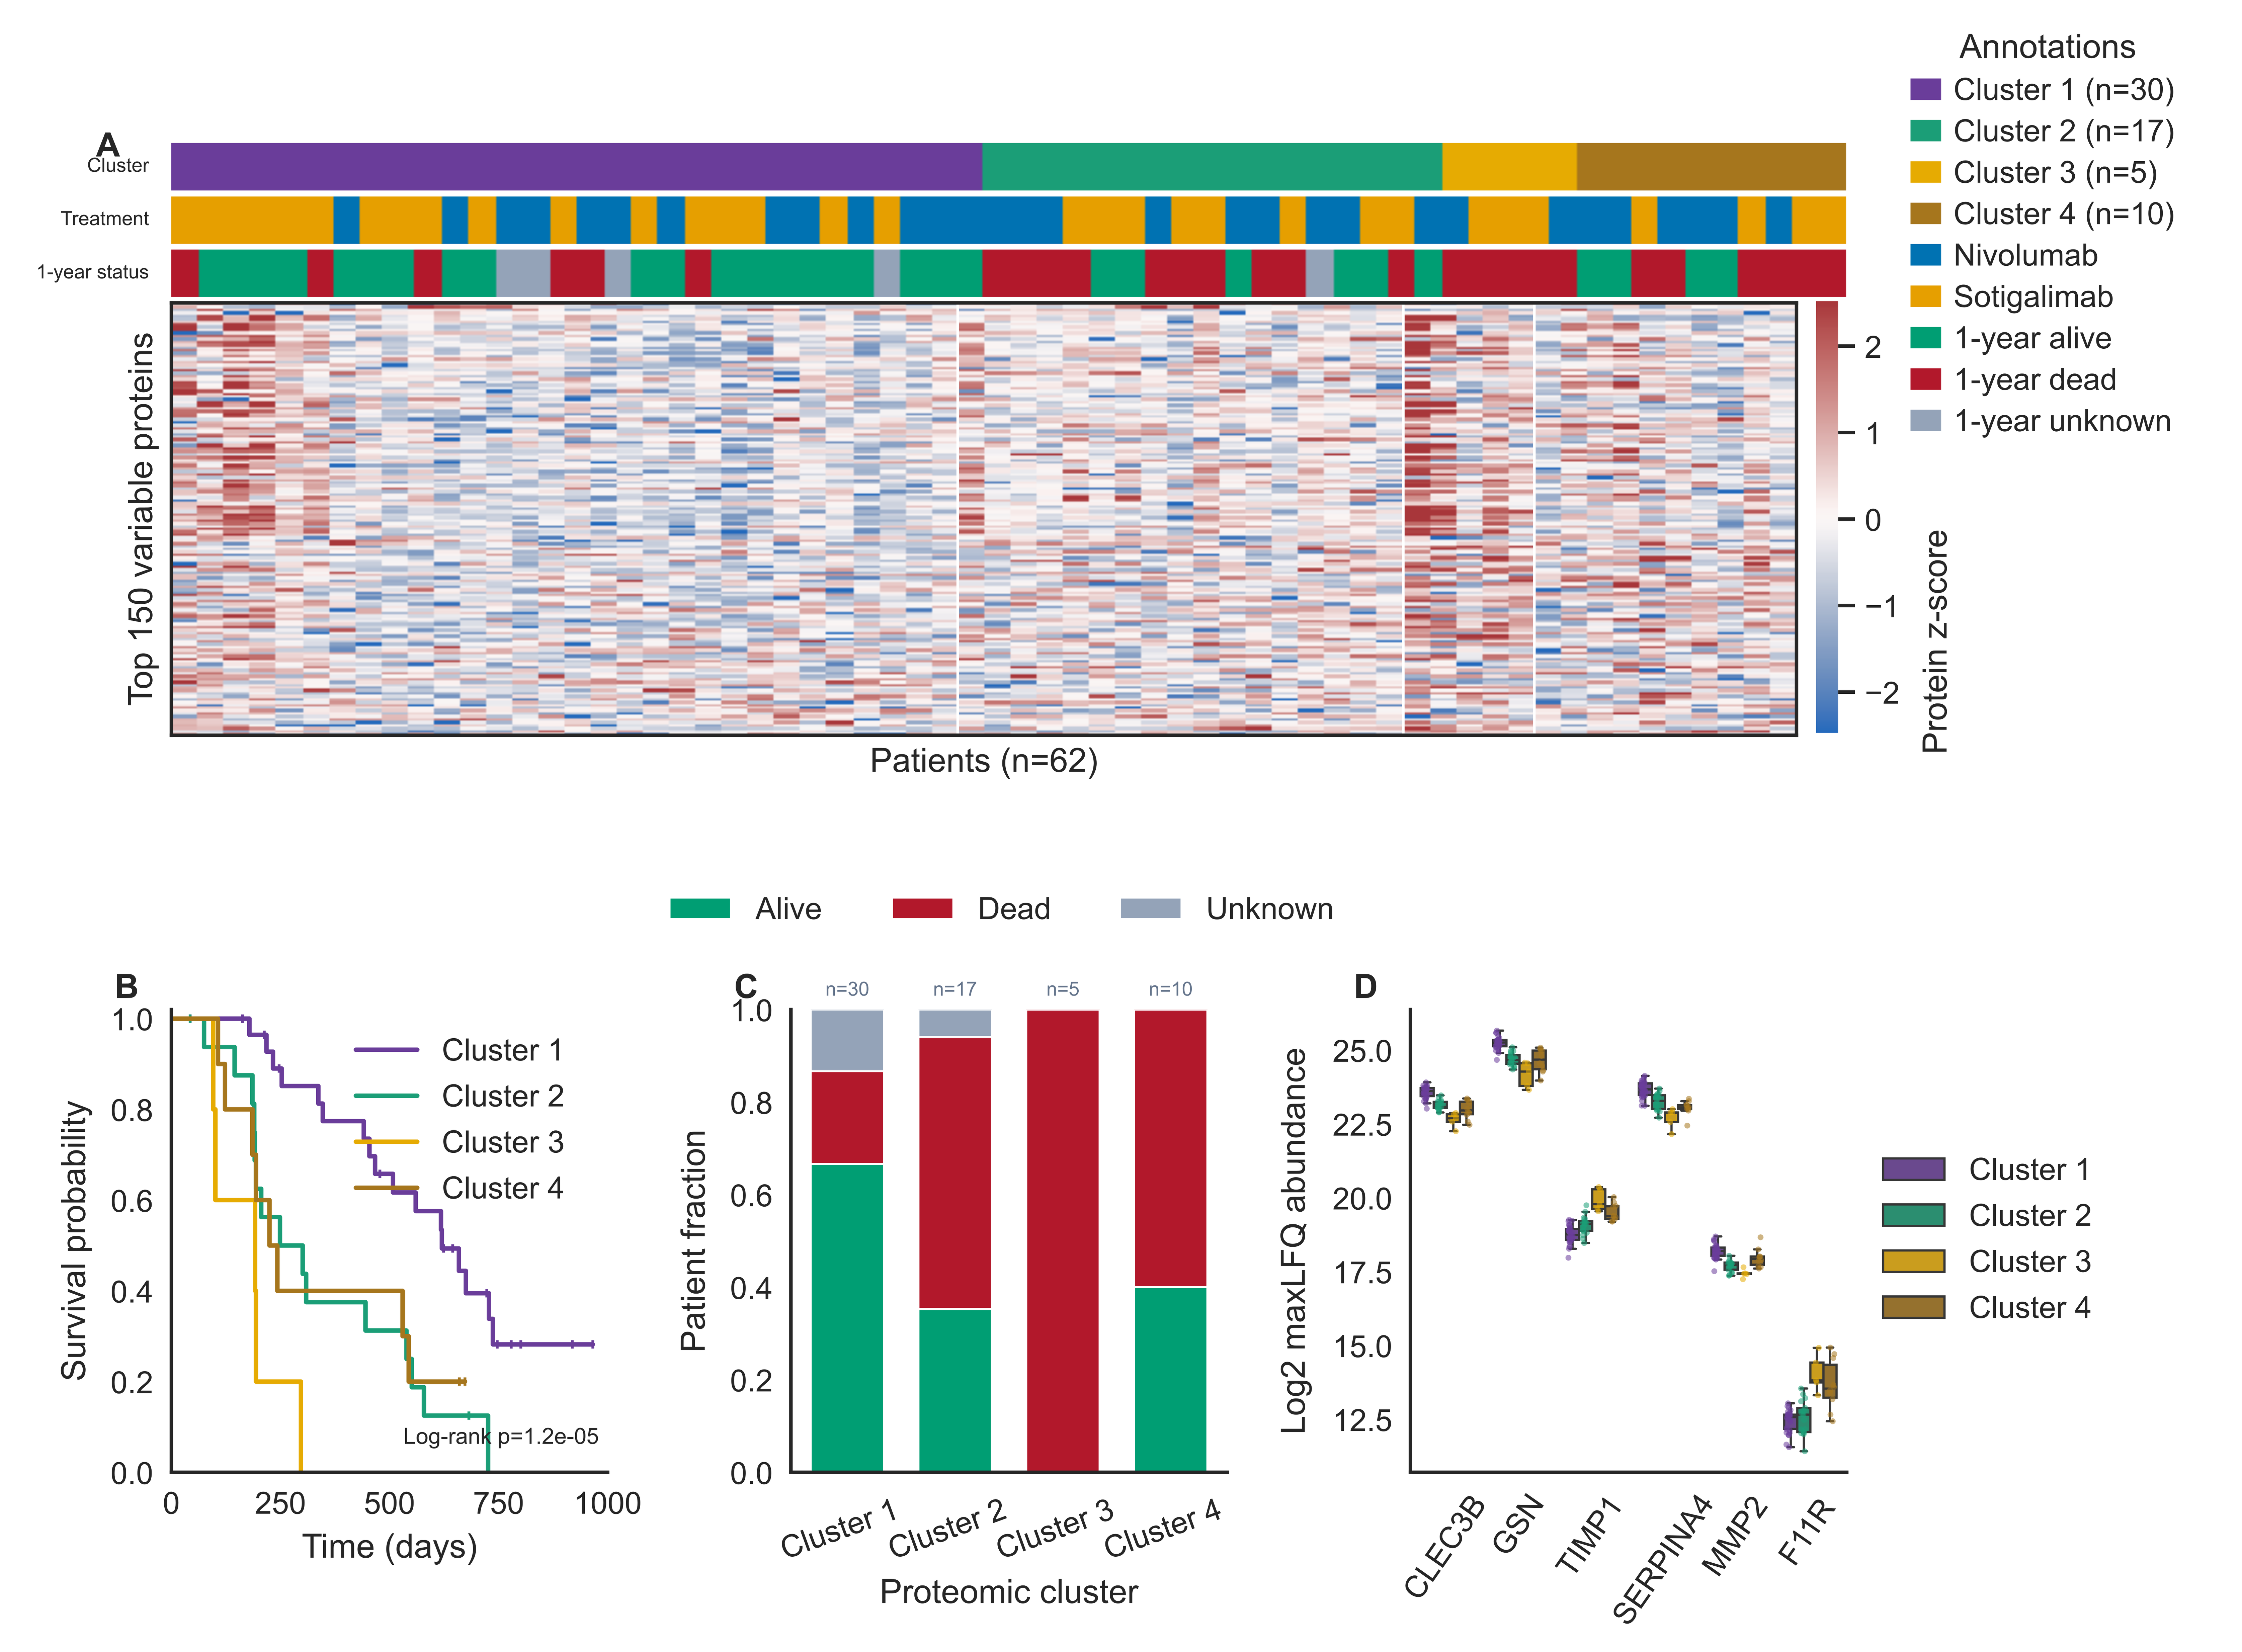
热图按基线蛋白模式归类患者,生存曲线与结局组成显示各亚群的随访表现。CLEC3B、GSN、TIMP1等蛋白的个体丰度图进一步说明亚群差异由怎样的患者分布构成,并显示各亚群内部的离散和重叠。
图3 临床因素与全蛋白范围的生存关联
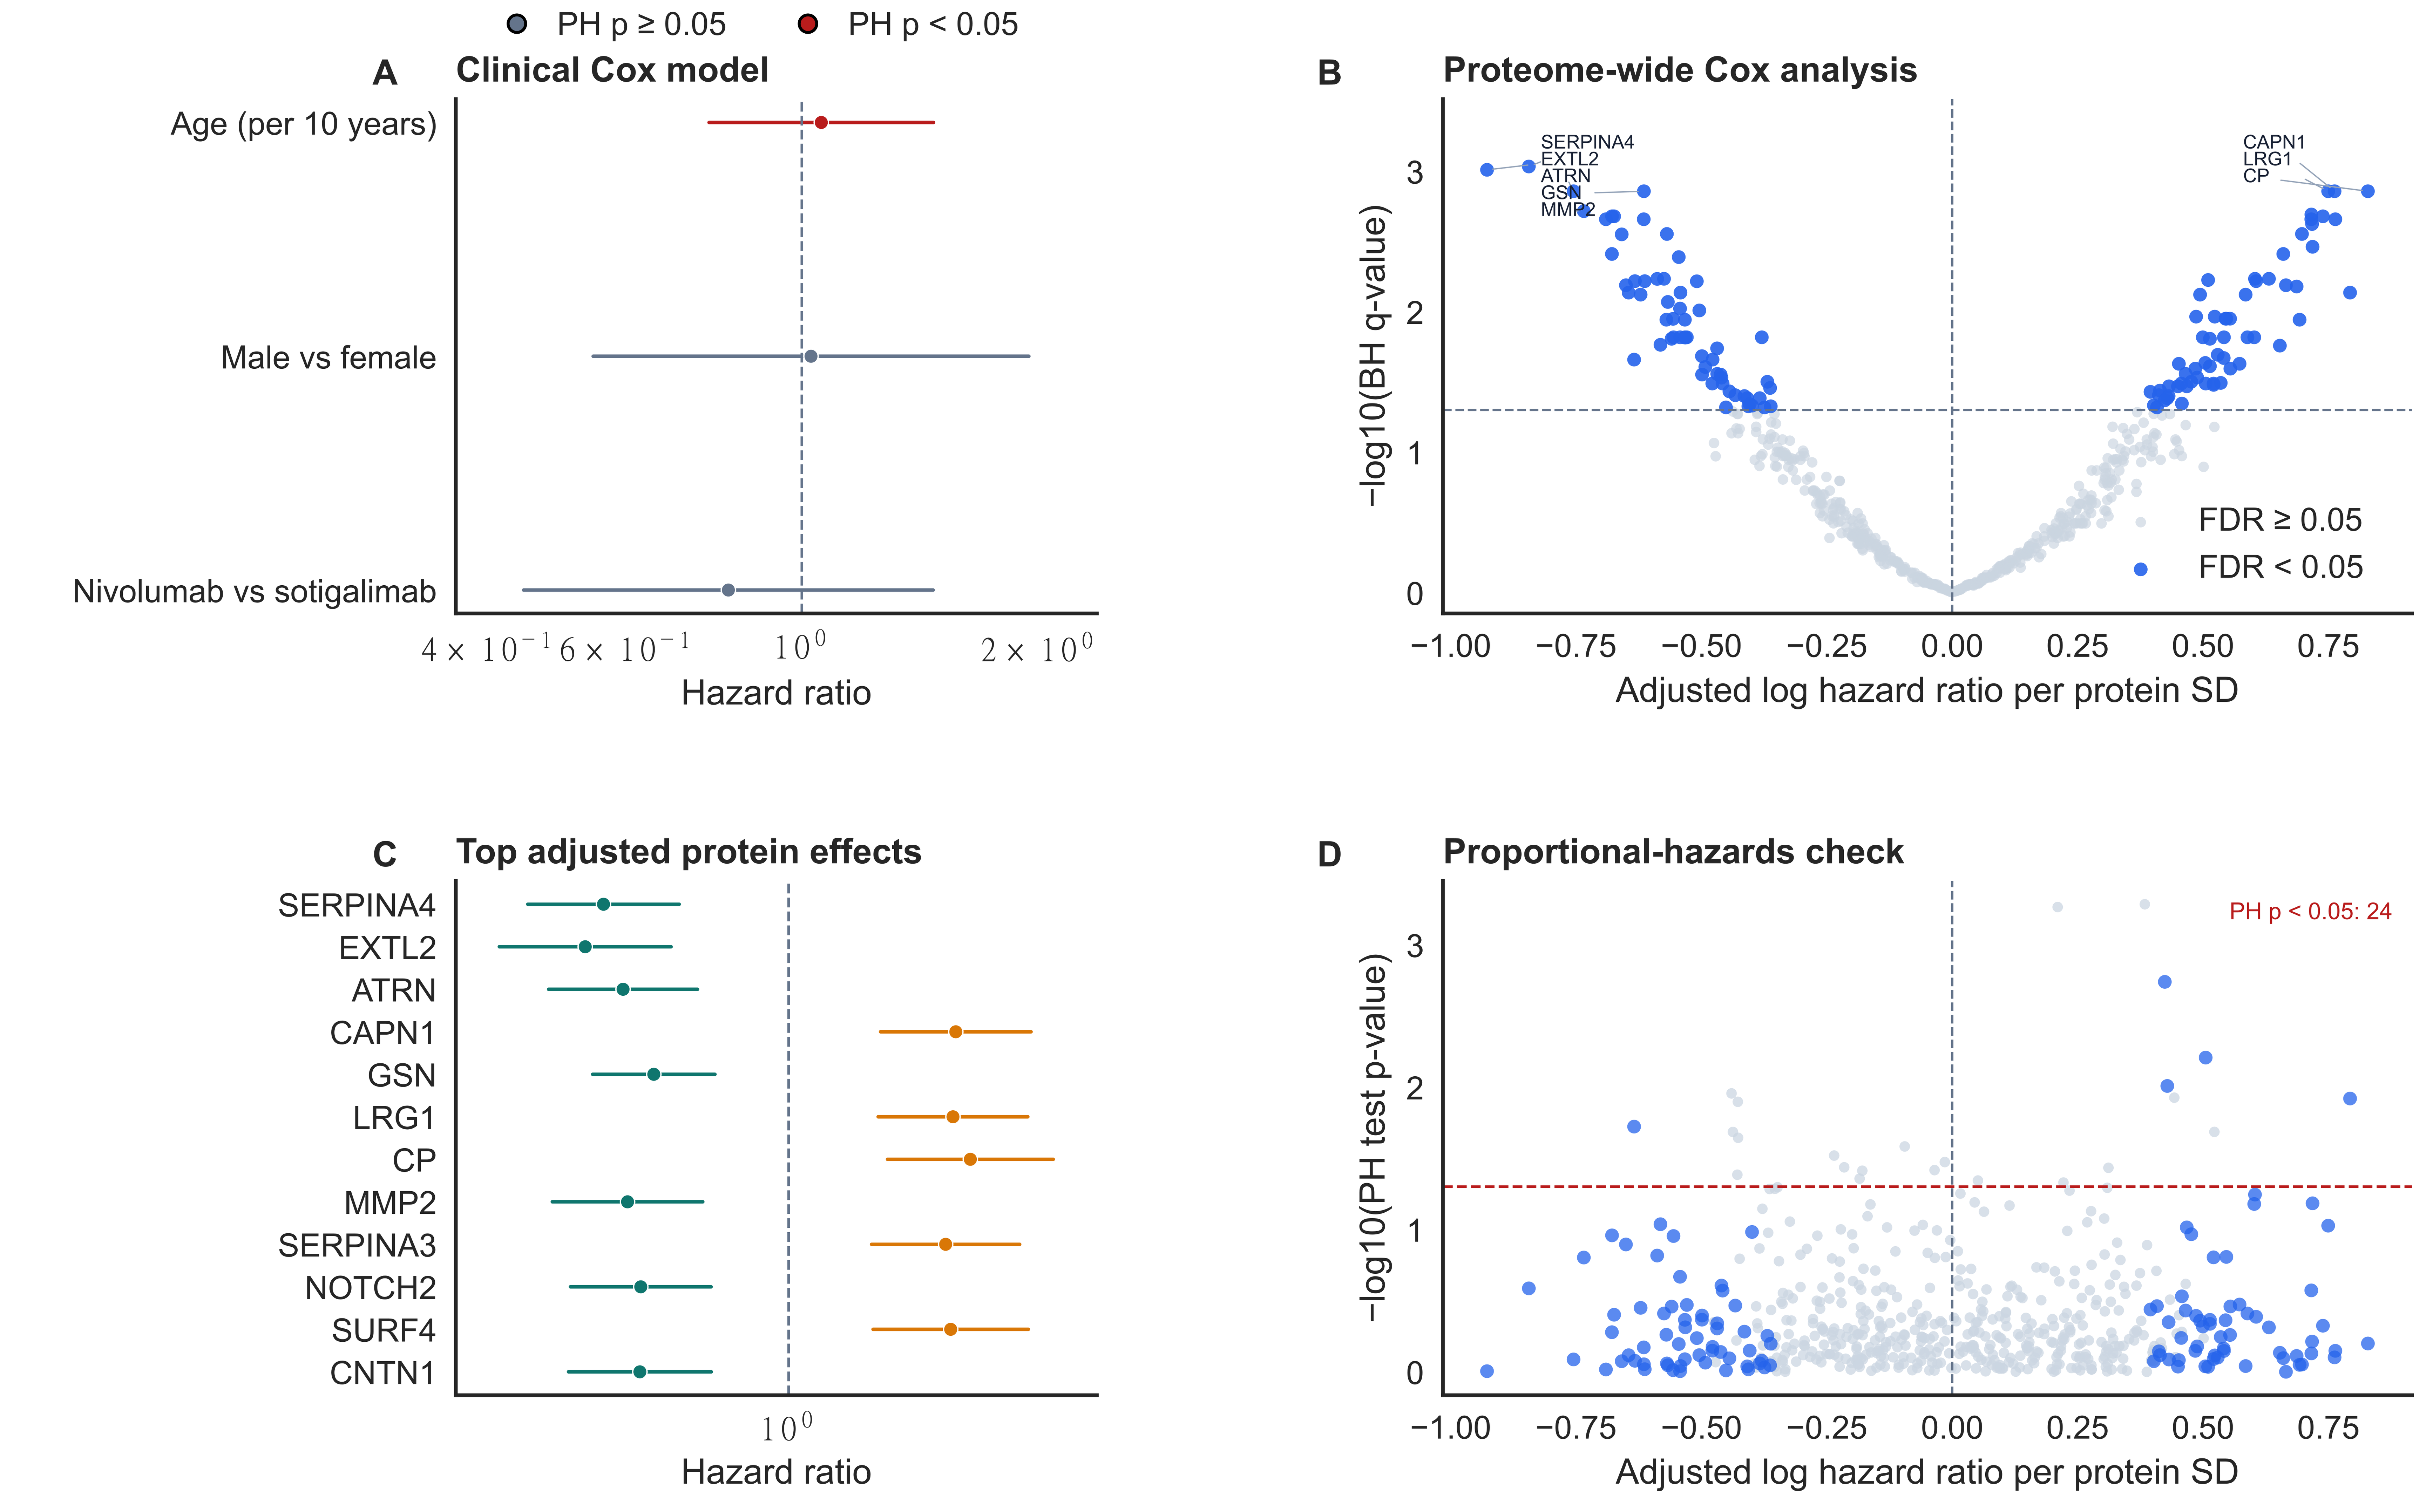
全蛋白图按效应方向和统计结果展示关联分布,森林图保留代表蛋白的风险比与估计区间。比例风险检验考察风险比在随访期间保持恒定的假设;候选效应及这一检验共同决定相应关联适合采用恒定还是时间相关的效应描述。
图4 文献候选蛋白的队列关联与治疗组差异

同一候选分别展示全队列关联、组内风险比和交互项。组内估计描述各治疗条件下的关系,交互项评价两组关联的差异;效应区间与患者丰度分布补充估计精度及样本信息,明确各项比较的含义。
图5 惩罚Cox模型的蛋白选择与系数稳定性
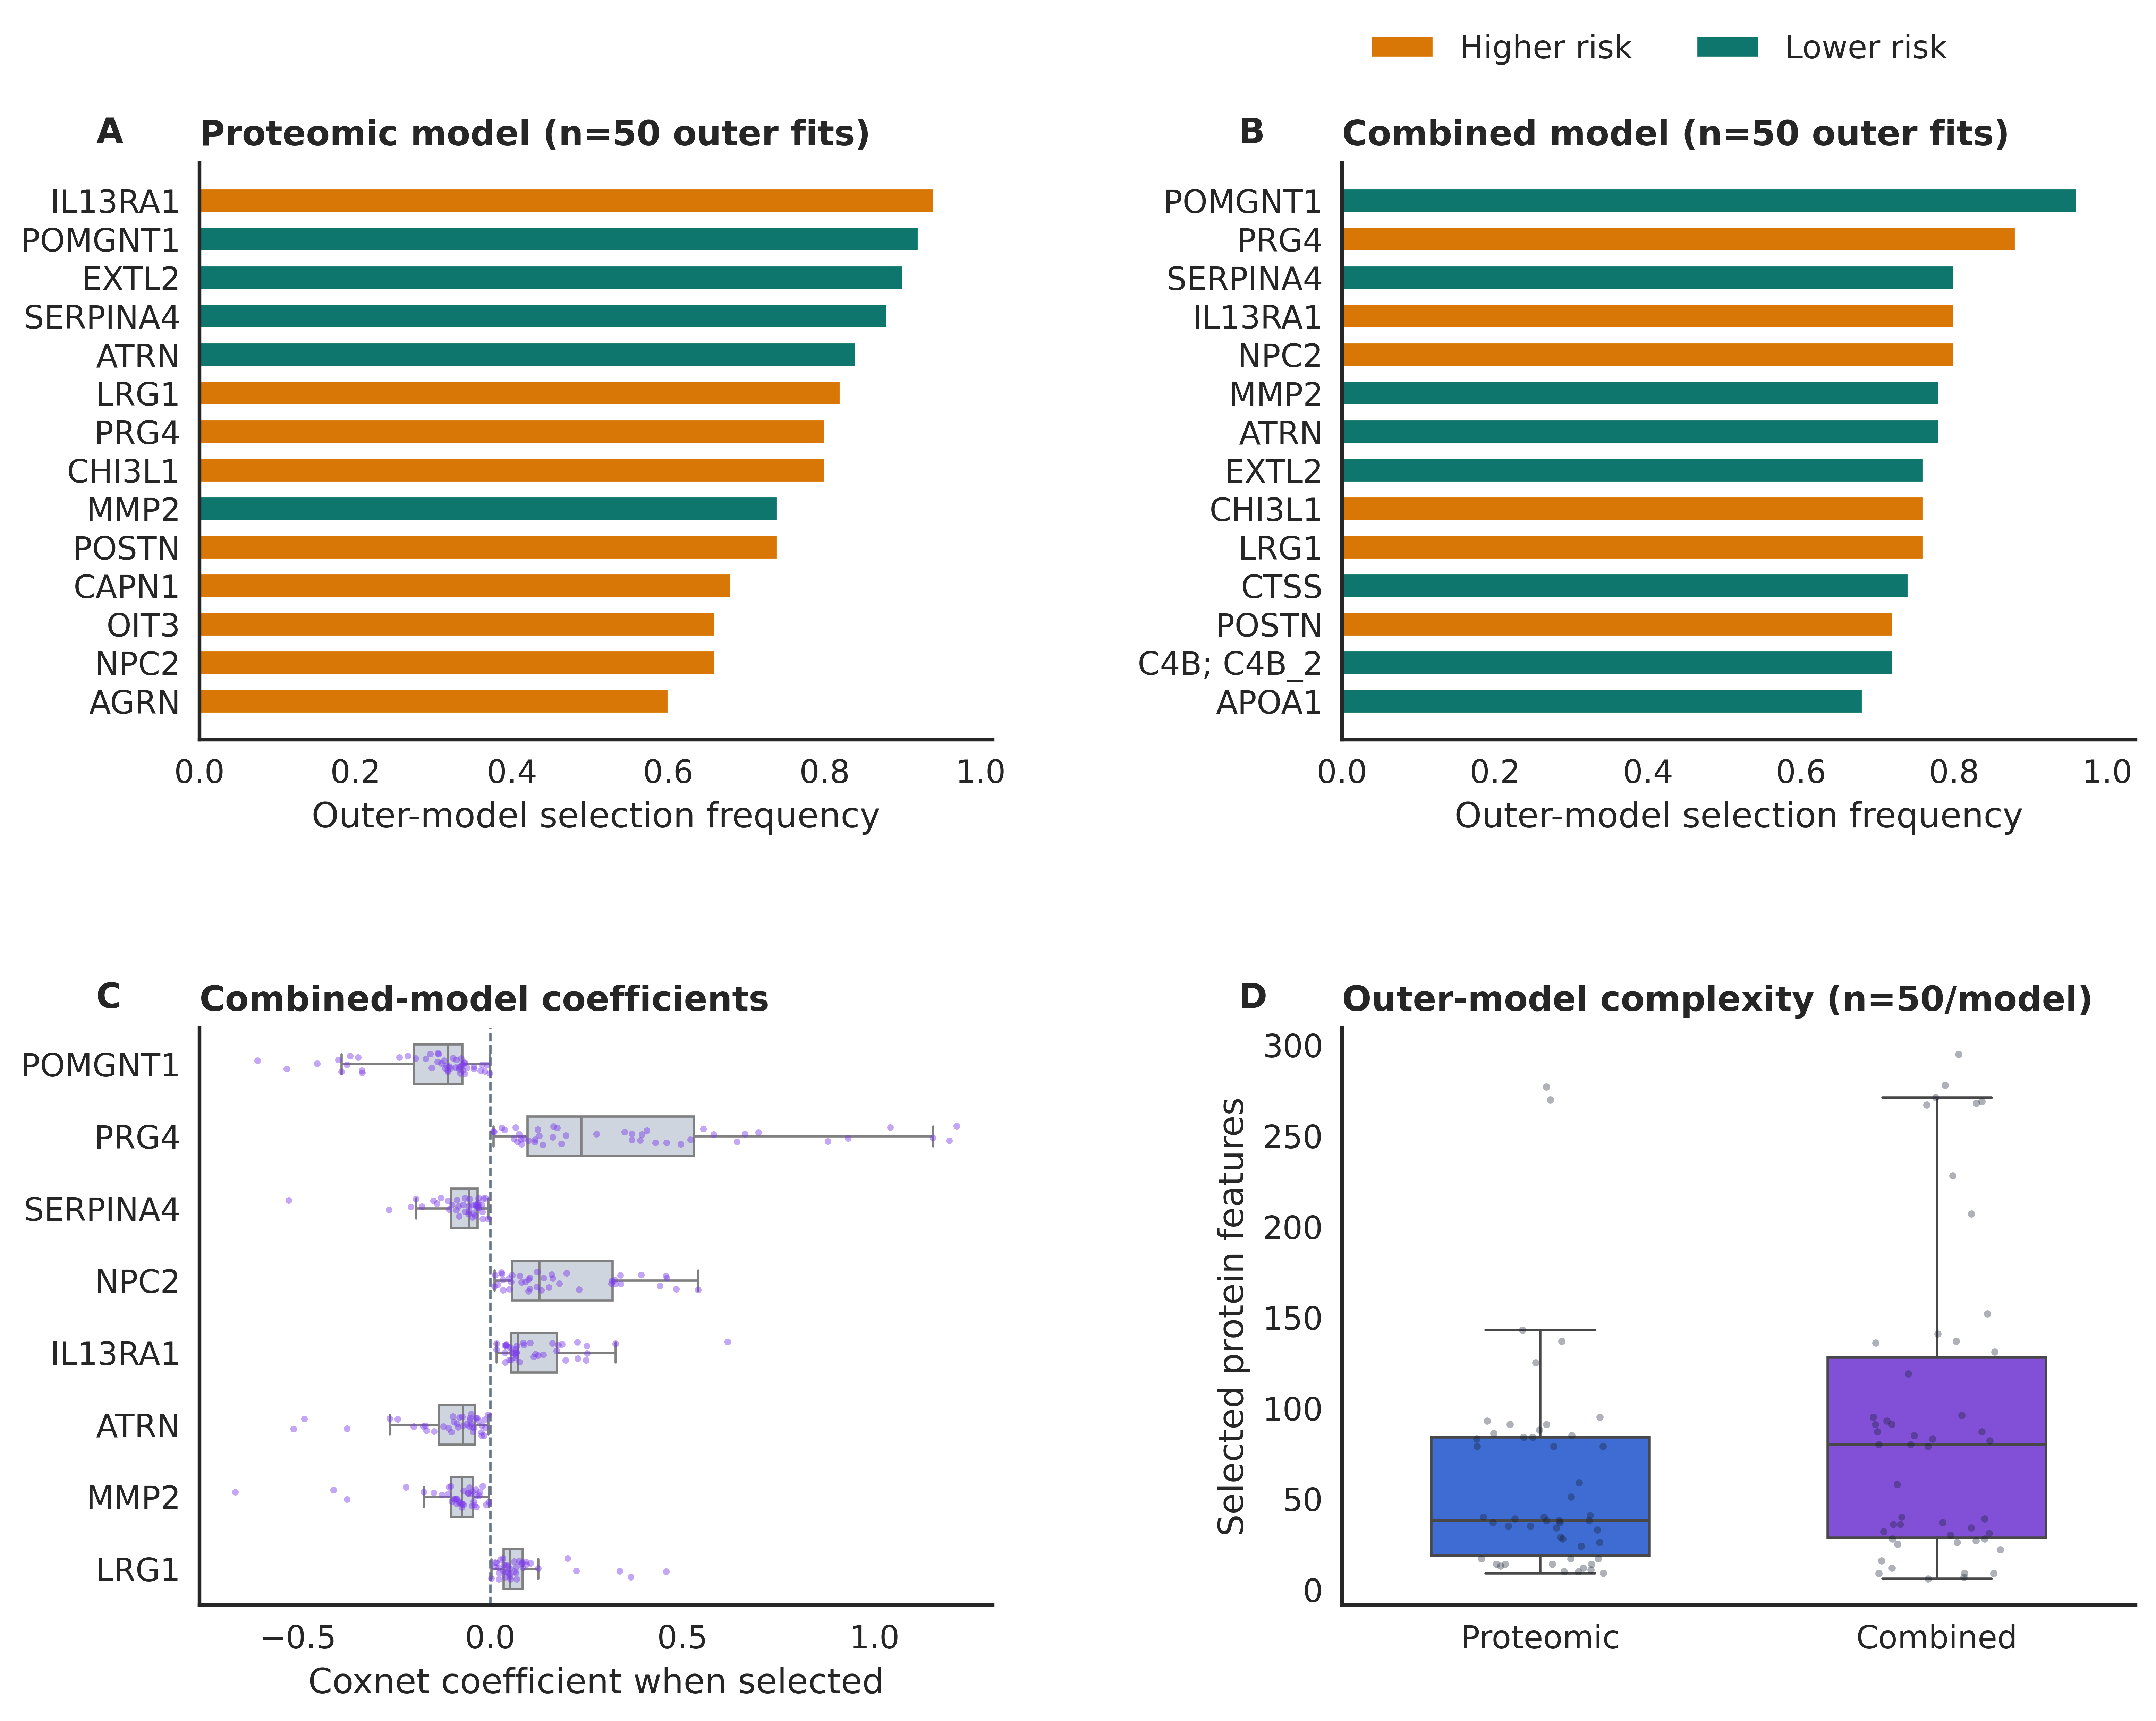
入选频率显示候选随训练样本变化的重复出现程度,系数分布保留其入选时的方向和幅度,各次蛋白数量显示模型规模。蛋白模型与联合模型的候选排序可直接对照,辨认加入临床变量后哪些蛋白保持稳定、哪些更依赖训练样本。
图6 临床 蛋白与联合生存模型的折外区分度
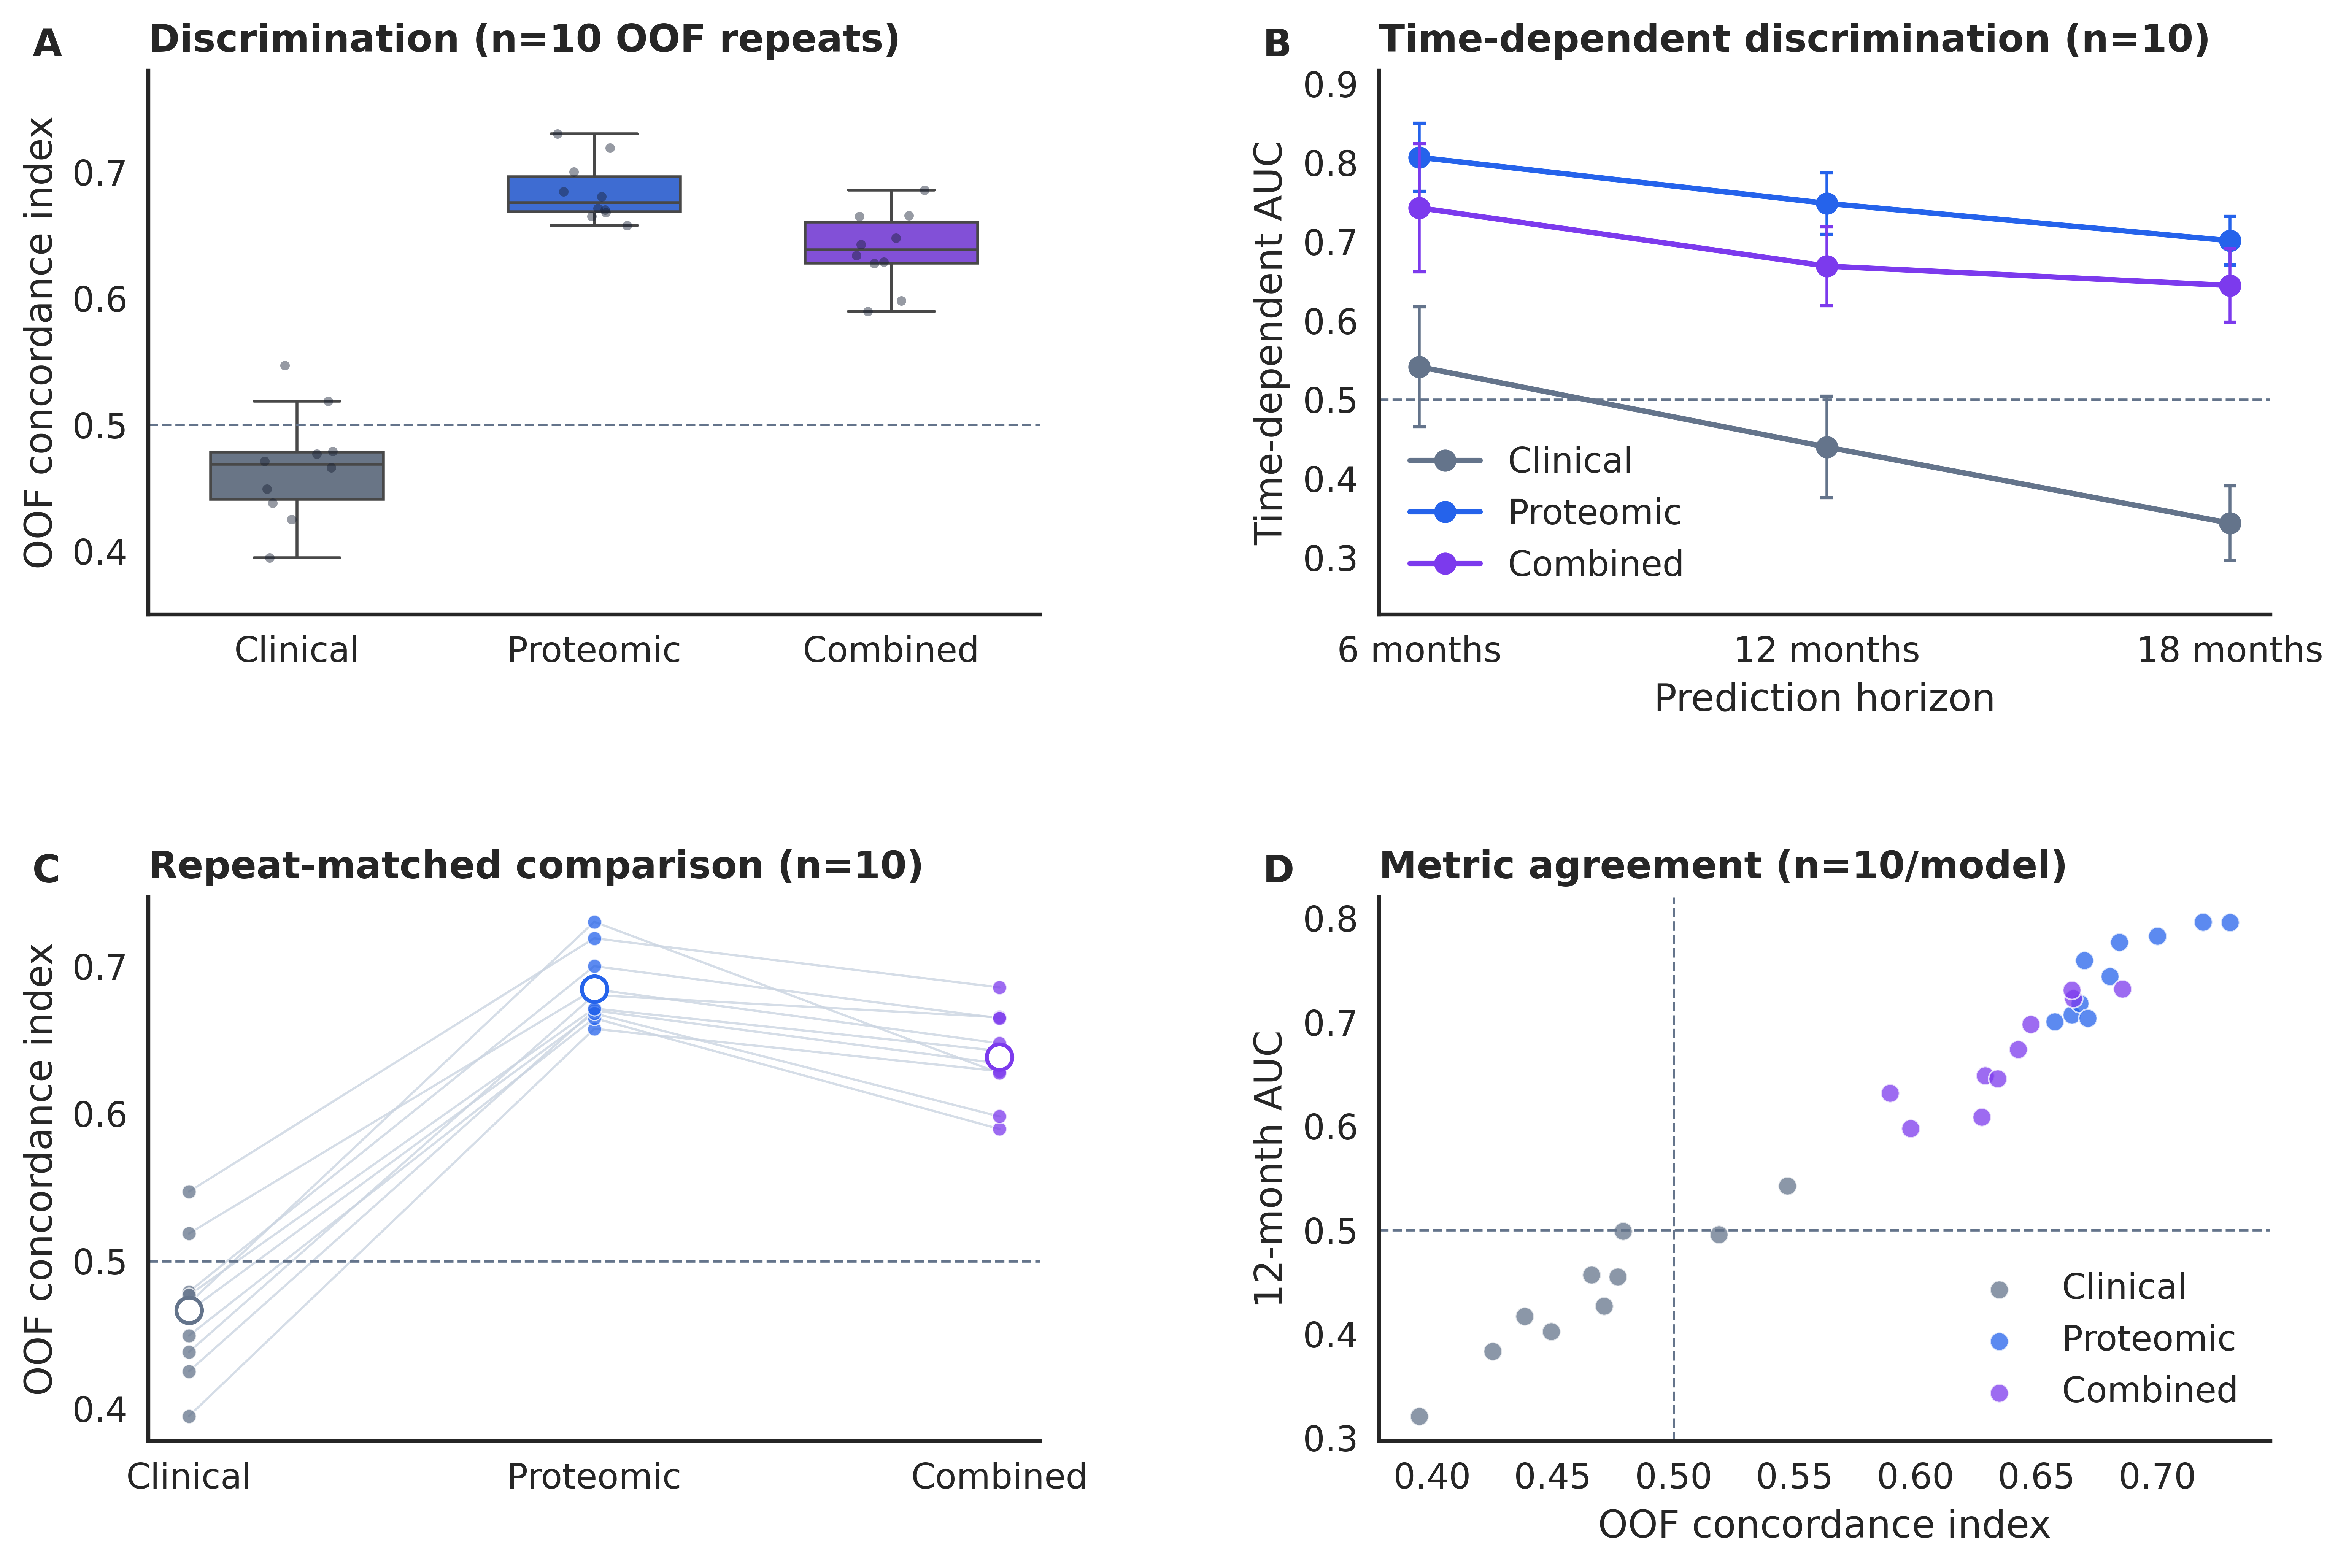
C指数概括生存风险排序,时间依赖AUC显示不同随访窗口的区分度。同次患者划分的配对结果比较模型差异,不同重复的分布显示这一差异的波动,从而分别呈现加入蛋白信息后的性能变化及其稳定程度。
图7 生存概率校准与不同随访期的预测误差
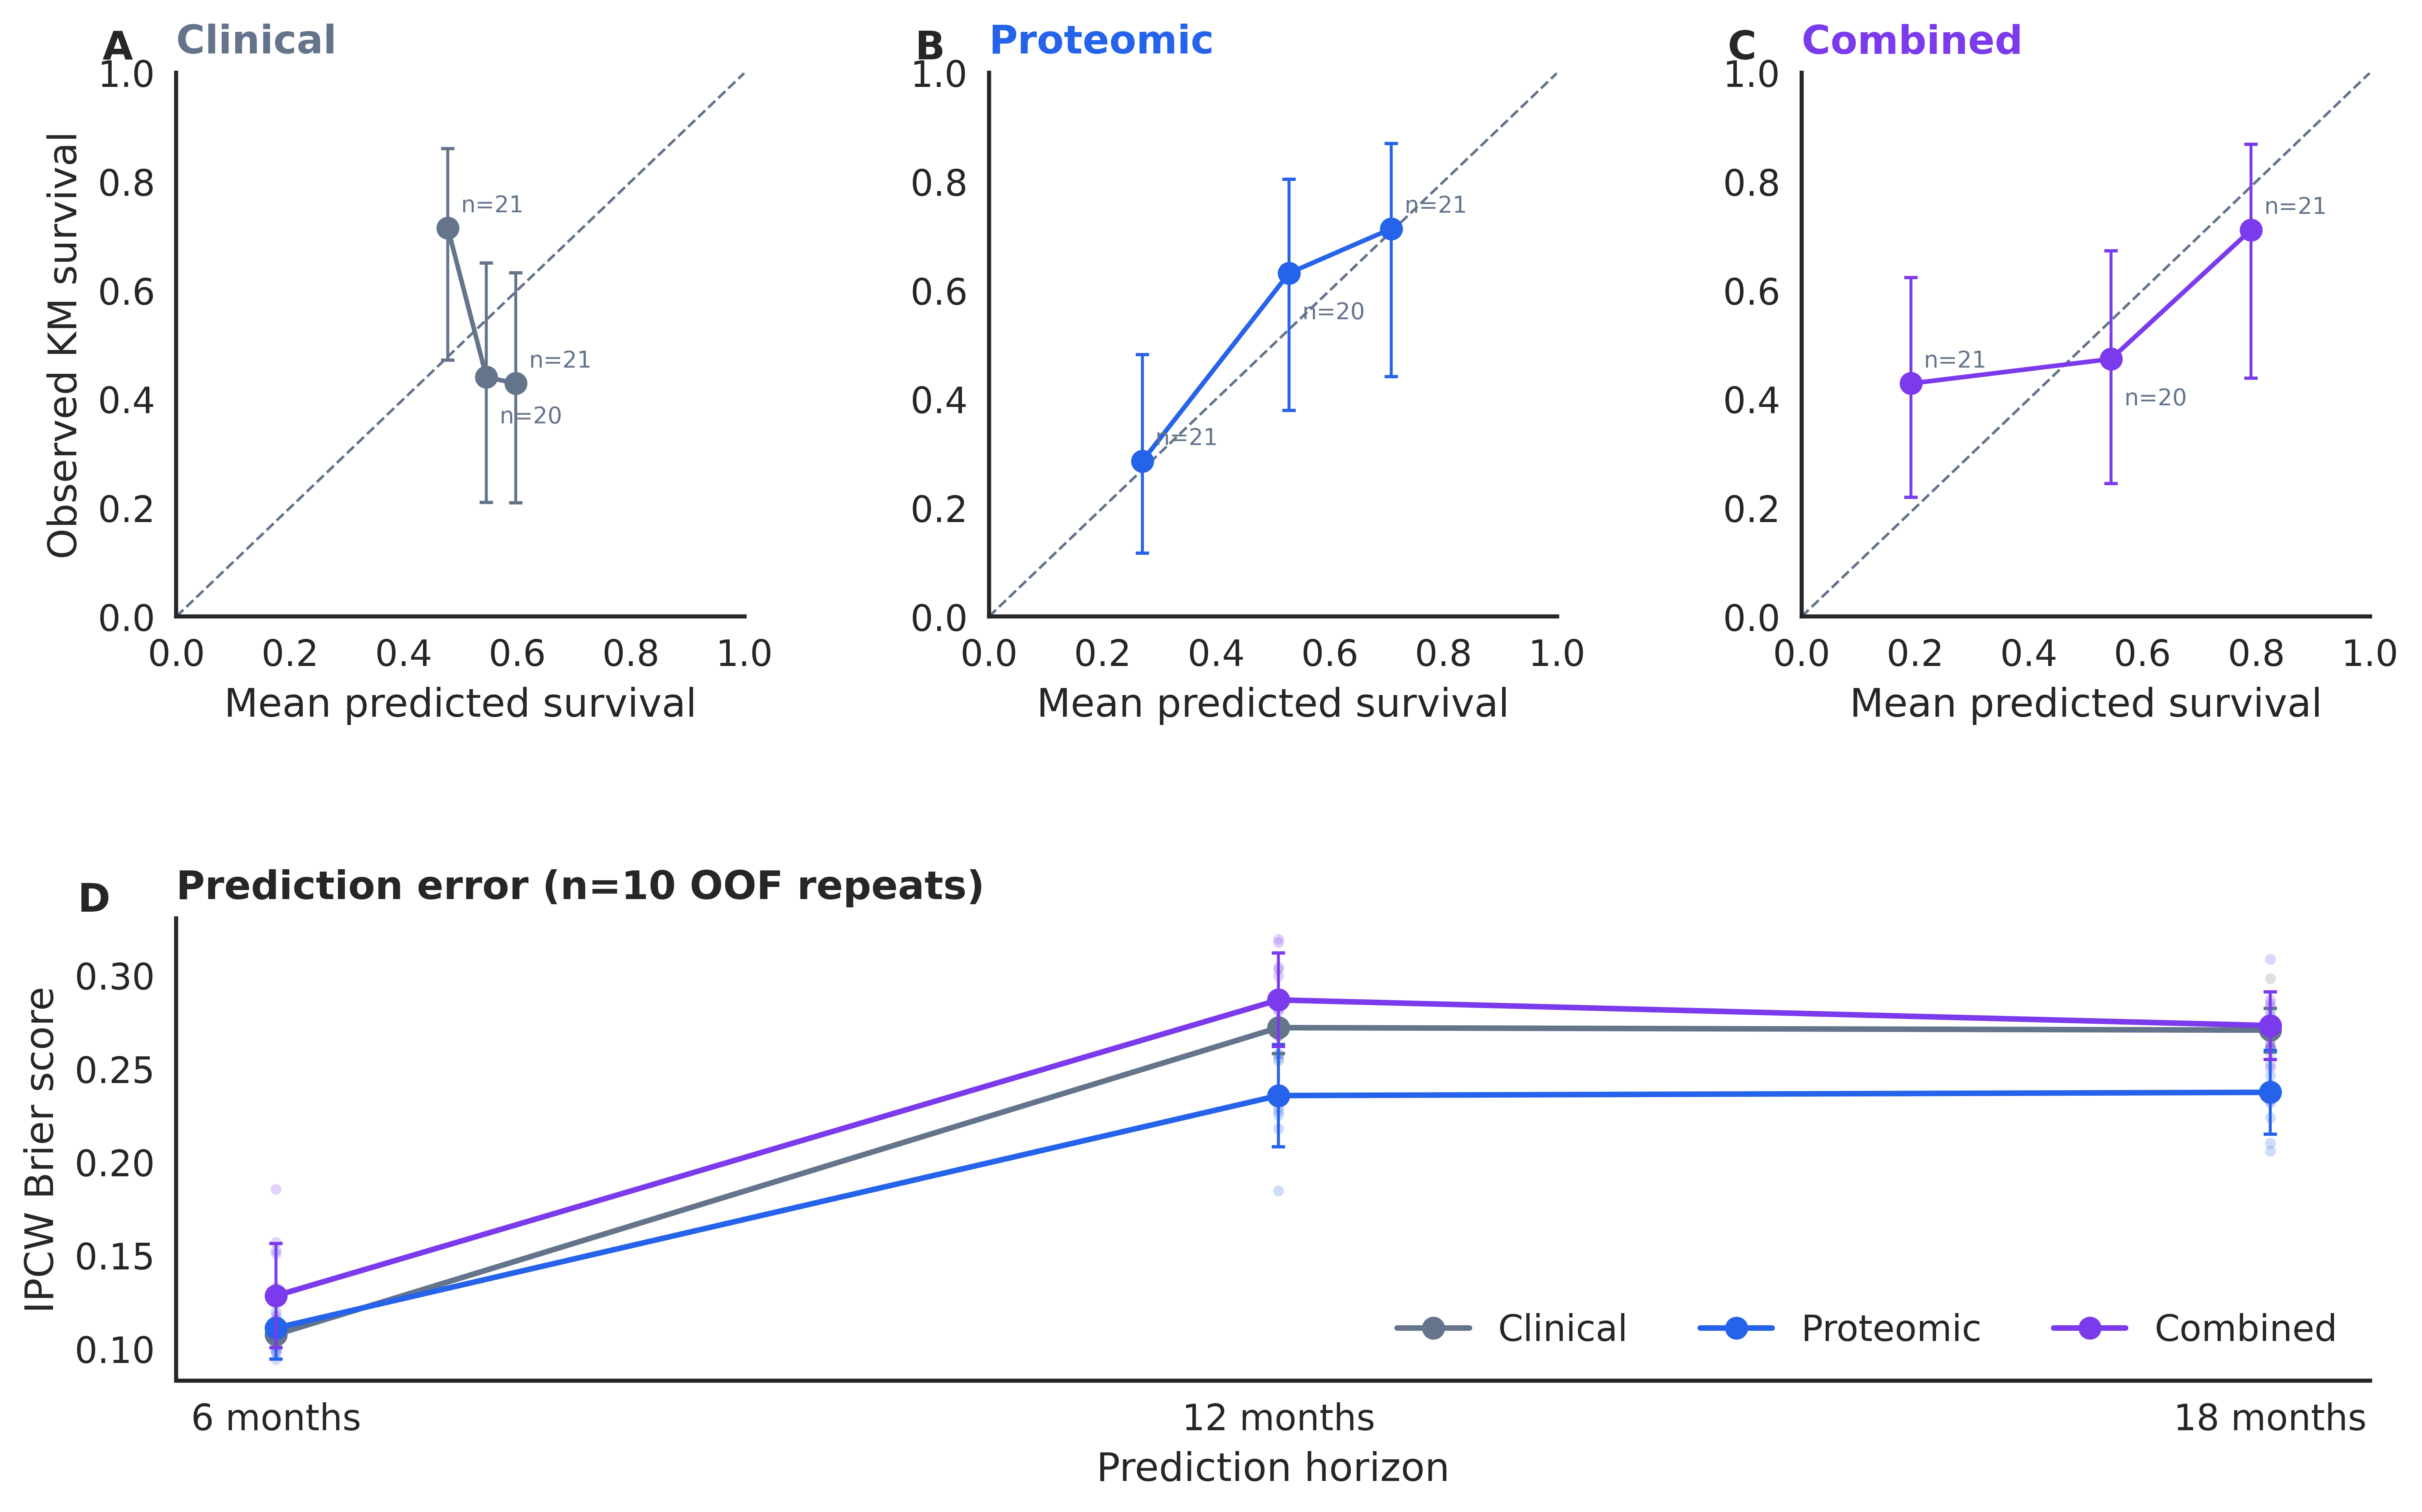
预测生存概率与随访估计越接近,校准曲线越靠近理想一致关系。Brier误差汇总预测概率与结局的差距,并以删失权重利用随访信息;各时间窗口的结果显示概率预测误差如何随评价时间变化。
图8 患者折外风险评分与随访结局分层
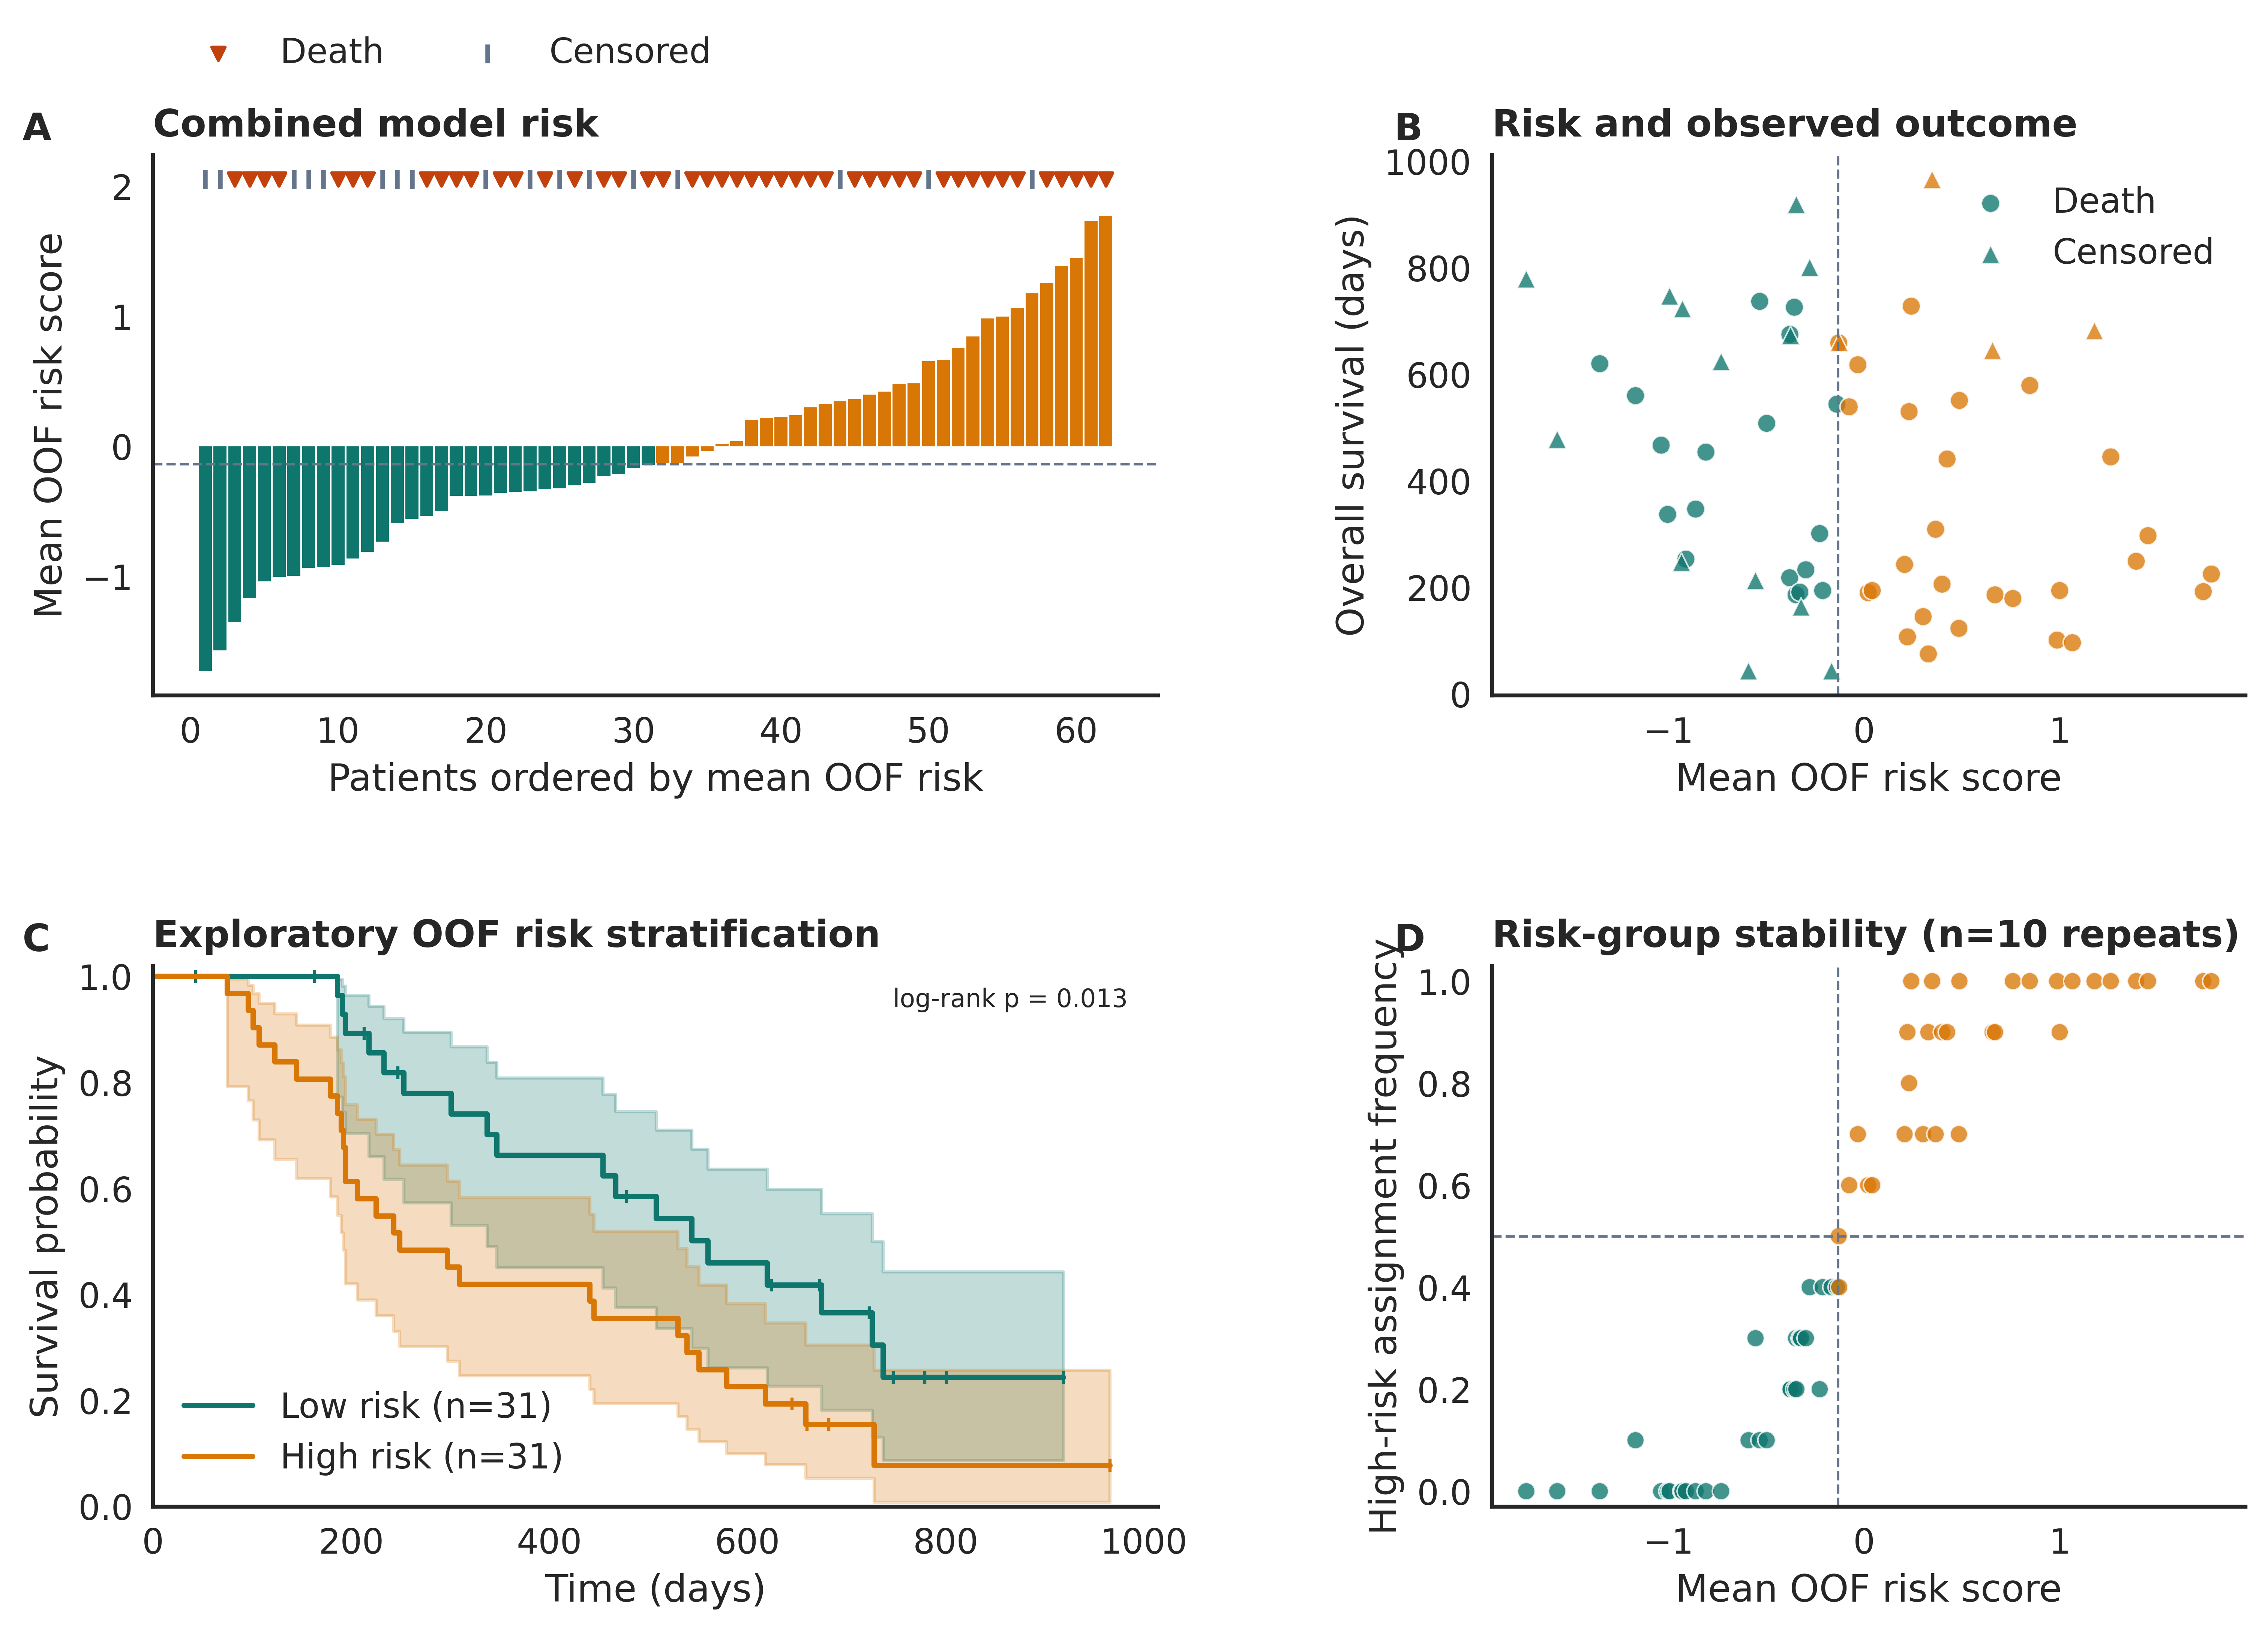
连续评分、事件状态和随访时长按患者排列,显示风险排序与实际结局的对应。重复分组频率记录同一患者随训练样本变化而进入高风险组的情况,尤其显示中间评分患者归属是否稳定,补充单次分组生存曲线的信息。
图9 一年生存状态的分类建模示例
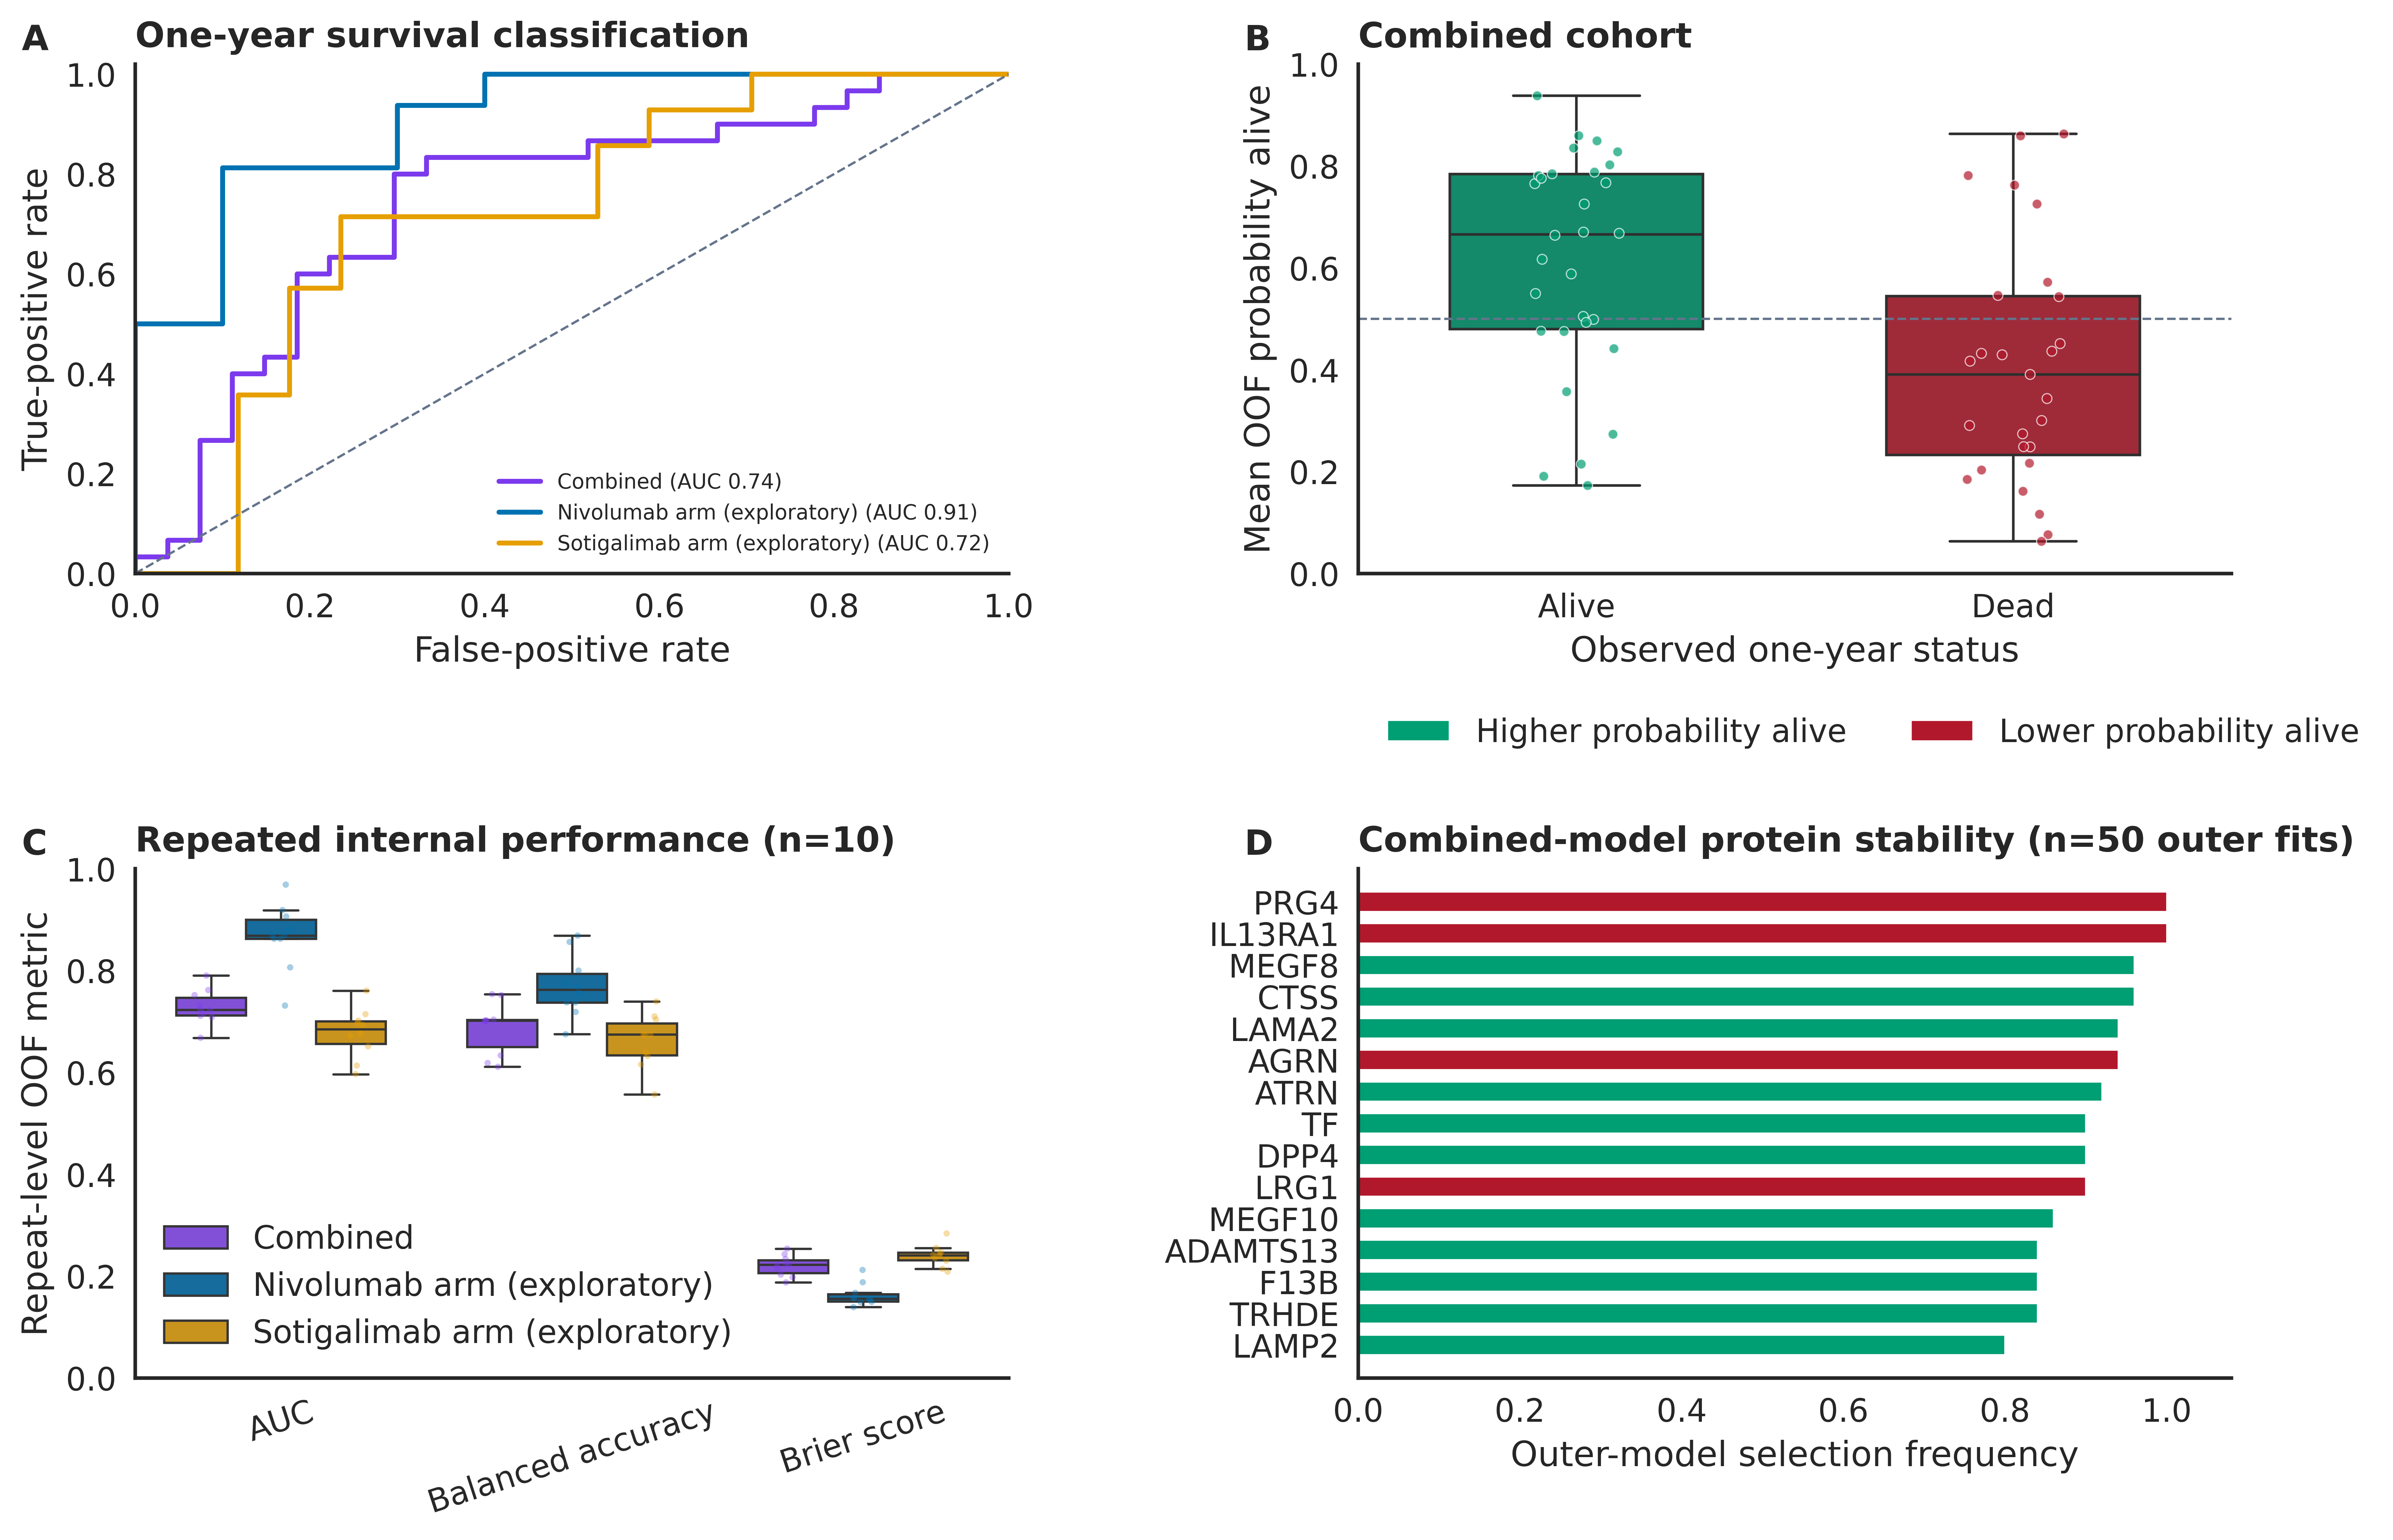
一年状态确定的患者进入固定时点分类分析,概率分布显示这一目标下的患者评分差异。重复建模同时记录性能与候选组成的波动,整体和治疗组结果按同一时间窗比较,并与保留完整随访时长的生存模型相互参照。
项目咨询
请提供研究问题、样本类型与数量、分组方式,以及已有的病理、临床、随访或配套组学资料。已有检测结果可附报告目录或数据字段说明。
邮件咨询 · multiomics@omicsolution.com